[](https://github.com/jung-geun/PSO/actions/workflows/pypi.yml)
[](https://pypi.org/project/pso2keras/)
# PSO (pso2keras)
Particle Swarm Optimization for PyTorch models (Version 4.0.0).
`pso2keras`는 PyTorch `nn.Module` 모델 최적화를 위한 5단계 플러그인 아키텍처 기반의 미분 무관(Derivative-Free) Particle Swarm Optimization (PSO) 라이브러리입니다. v4.0.0부터 최적화 프로세스가 독립적으로 선택 가능한 5가지 스테이지(`method`, `initialization`, `evaluation`, `convergence`, `refinement`)로 정밀 분리되었습니다.
기본 PSO 알고리즘 탐색은 역전파(`loss.backward()`) 없이 순전파 적합도 평가로만 동작하며, 필요 시 옵션 후처리인 하이브리드 Adam 미세조정(`refinement="adam"`)을 결합할 수 있습니다. macOS Metal Performance Shaders (MPS) 디바이스 가속, 재현 가능한 시드 제어, 가중치 바운드(`particle_min`/`particle_max`), 속도 제한 및 반사 경계, 고정 서브셋 적합도 평가, 정체 파티클 재초기화, 다종 논문 고전 무브먼트 알고리즘과 함께 다차원 수렴 실험 환경을 제공합니다.
Tested on **Python 3.10 / 3.11** with **PyTorch >= 2.13**.
---
## 목차
- [설치 및 환경](#설치-및-환경)
- [Metal MPS 가속 및 디바이스 선택](#metal-mps-가속-및-디바이스-선택)
- [빠른 시작 (Quick Start)](#빠른-시작-quick-start)
- [5단계 플러그인 아키텍처 (5-Stage Plugin Architecture)](#5단계-플러그인-아키텍처-5-stage-plugin-architecture)
- [무브먼트/알고리즘 매트릭스 (Method Comparison Matrix)](#무브먼트알고리즘-매트릭스-method-comparison-matrix)
- [기법 분류 및 방법론 명확화 (Method Categorization)](#기법-분류-및-방법론-명확화-method-categorization)
- [미지원 논문 기법 및 확장 계획 (Unsupported Paper Methods)](#미지원-논문-기법-및-확장-계획-unsupported-paper-methods)
- [API 레퍼런스](#api-레퍼런스)
- [Optimizer 생성자](#optimizer-생성자)
- [fit 메서드](#fit-메서드)
- [적응형 모멘트 PSO (Adaptive Moment PSO - 저장소 독자 실험)](#적응형-모멘트-pso-adaptive-moment-pso---저장소-독자-실험)
- [하이브리드 Adam 미세조정 (Hybrid Refinement)](#하이브리드-adam-미세조정-hybrid-refinement)
- [결과 조회 메서드](#결과-조회-메서드)
- [비교 CLI 도구 (Method Comparison CLI)](#비교-cli-도구-method-comparison-cli)
- [실전 튜닝 및 벤치마크 (Tuning & Benchmark Results)](#실전-튜닝-및-벤치마크-tuning--benchmark-results)
- [PSO v4 다중 시드 실증 보고서 (Multi-Seed Empirical Report)](#pso-v4-다중-시드-실증-보고서-multi-seed-empirical-report)
- [확장 튜닝 및 파티클 스케일링 (Extended Tuning & Particle Scaling)](#확장-튜닝-및-파티클-스케일링-extended-tuning--particle-scaling)
- [공식 MNIST Deep Accuracy 프로토콜 (Deep Accuracy Protocol 1.0.0)](#공식-mnist-deep-accuracy-프로토콜-deep-accuracy-protocol-100)
- [Heavy PSO 고정 부분공간 반복 연구 (Heavy PSO Autoresearch 1.0.0)](#heavy-pso-고정-부분공간-반복-연구-heavy-pso-autoresearch-100)
- [Heavy PSO 교차 분할 강건성 검증 (Heavy PSO Cross-Split 1.0.0)](#heavy-pso-교차-분할-강건성-검증-heavy-pso-cross-split-100)
- [Post-Training Prediction-Space Ensemble 연구 (PSO v8)](#post-training-prediction-space-ensemble-연구-pso-v8)
- [역사적 단일 시드 레퍼런스 (Historical Seed 42 Reference)](#역사적-단일-시드-레퍼런스-historical-seed-42-reference)
- [출력 아티팩트 구조](#출력-아티팩트-구조)
- [프로젝트 구조](#프로젝트-구조)
- [보안 관련 참고 사항](#보안-관련-참고-사항)
- [참고 문헌 (Primary References & DOIs)](#참고-문헌-primary-references--dois)
---
## 설치 및 환경
### PyPI 설치 및 패키지 추가
`uv` 프로젝트에서 사용 시:
```shell
uv add pso2keras
```
기존 `pip` 환경에서 사용 시:
```shell
pip install pso2keras
```
예제 데이터셋(Torchvision, Pandas, UCI Machine Learning Repository 지원) 지원 기능과 함께 설치할 경우:
```shell
uv add "pso2keras[examples]"
```
### 개발 및 환경 관리 (uv 기반)
`pso2keras`는 Python 프로젝트 및 의존성 관리를 위해 [`uv`](https://github.com/astral-sh/uv)를 사용합니다.
```shell
# Python 3.11 버전 설치 및 프로젝트 동기화
uv python install 3.11
uv sync --locked --group dev --extra examples
# 오프라인 pytest 테스트 수트 실행
uv run pytest -q
# XOR 수렴 실험 실행
uv run python test/xor.py
# 다종 알고리즘 비교 CLI 실행
uv run python test/compare_methods.py --dataset xor --methods original inertia constriction fips clpso bare_bones adaptive_moment local_best quantum --seeds 42 43 44
```
---
## Metal MPS 가속 및 디바이스 선택
`pso2keras`는 macOS Metal Performance Shaders (MPS) 및 NVIDIA CUDA, CPU 디바이스 연산을 모두 지원합니다.
```python
import torch
built = hasattr(torch.backends, "mps") and torch.backends.mps.is_built()
avail = hasattr(torch.backends, "mps") and torch.backends.mps.is_available()
print(f"MPS built: {built}, available: {avail}")
```
- **자동 선택 (`device=None`, 기본값)**: `mps` -> `cuda` -> `cpu` 순으로 사용 가능 여부를 진단하여 자동 할당합니다.
- **명시적 지정 (`device="mps"`, `device="cuda"`, `device="cpu"`)**: 지원되지 않는 디바이스 요청 시 `RuntimeError`를 발생시키며, CPU로 암묵적 대체되지 않습니다.
---
## 빠른 시작 (Quick Start)
PyTorch `nn.Module`과 `BCEWithLogitsLoss`를 사용한 XOR 문제 최적화 예제입니다:
```python
import torch
import torch.nn as nn
from pso import Optimizer
# 1. 시드 설정 및 신경망 모델 정의
torch.manual_seed(101)
model = nn.Sequential(
nn.Linear(2, 4),
nn.Tanh(),
nn.Linear(4, 1),
)
loss_fn = nn.BCEWithLogitsLoss()
# 2. Optimizer 생성 (v4.0.0 5-Stage Plugin API)
pso = Optimizer(
model,
loss_fn,
task="binary",
method="original", # 1995 Kennedy & Eberhart 기본 PSO (c0=c1=2.0, w=1.0)
initialization="model_noise", # 모델 가중치 + 유니폼 노이즈 초기화
evaluation="full", # 전체 학습 데이터셋 평가
convergence="none", # 정체 재초기화 미사용
refinement="none", # 미분 기반 후처리 미사용 (100% 미분 무관)
n_particles=40,
particle_min=-5.0,
particle_max=5.0,
initial_position_noise=1.0,
seed=101,
device=None,
)
# 3. 데이터 텐서 준비
x_train = torch.tensor([[0.0, 0.0], [0.0, 1.0], [1.0, 0.0], [1.0, 1.0]], dtype=torch.float32)
y_train = torch.tensor([[0.0], [1.0], [1.0], [0.0]], dtype=torch.float32)
# 4. PSO 학습 실행
best_score = pso.fit(
x_train,
y_train,
epochs=100,
renewal="loss",
output_dir="./result/xor",
log_format="csv",
checkpoint_interval=25,
save_info=True,
)
# 5. 최적 결과 조회
best_score = pso.get_best_score() # (loss, accuracy, mse)
best_model = pso.get_best_model() # 최적 가중치가 반영된 eval() 모드 nn.Module
state_dict = pso.get_best_state_dict() # CPU 복사본 OrderedDict state_dict
print("Best score (loss, accuracy, mse):", best_score)
```
> **미분 무관(Derivative-Free) 최적화 노트**:
> 기본 PSO 알고리즘 탐색(`original`, `inertia`, `constriction`, `fips`, `clpso`, `bare_bones`, `adaptive_moment`, `local_best`, `quantum`)은 역전파(`loss.backward()`), 기울기(gradient) 계산, 또는 PyTorch Optimizer(`torch.optim`)를 전혀 사용하지 않고 `torch.inference_mode()`에서 순전파 적합도만 평가합니다. 단, 옵션 후처리인 하이브리드 Adam 미세조정 (`refinement="adam"` 및 `refinement_epochs > 0`)을 명시적으로 활성화할 때에만 전역 최적해($G_{best}$) 가중치에 대해 Adam 경사하강법을 수행합니다.
---
## 5단계 플러그인 아키텍처 (5-Stage Plugin Architecture)
v4.0.0부터 Optimizer의 모든 동작은 5가지 독립적인 단계(Stage) 플러그인으로 캡슐화되어 있습니다:
```
+-----------------------------------------------------------------------------------+
| Optimizer.fit() |
+-----------------------------------------------------------------------------------+
|
+--> 1. Initialization Stage ("model_noise" | "uniform")
| : 파티클 초기 위치 및 속도 벡터 생성
|
+--> 2. Evaluation Stage ("full" | "fixed_subset")
| : 세대별 적합도 평가 데이터 분할 및 고정 서브셋 관리
|
+--> 3. Movement Stage ("original" | "inertia" | "constriction" | "fips" | ...)
| : SwarmState 스냅샷 기반 속도 및 위치 이동 제안 (Engine Invariants 적용)
|
+--> 4. Convergence Stage ("none" | "particle_reset" | "early_stopping")
| : 정체 파티클 재초기화 판정 및 이탈 제어
|
+--> 5. Refinement Stage ("none" | "adam")
: PSO 탐색 완료 후 전역 최적해($G_{best}$) 가중치 대상 미세조정
```
1. **Movement Stage (`method`)**: 파티클의 제안 속도 및 위치 이동식을 결정합니다. (`original`, `inertia`, `constriction`, `fips`, `clpso`, `bare_bones`, `adaptive_moment`, `local_best`, `quantum`)
2. **Initialization Stage (`initialization`)**: 파티클 초기 위치 및 속도 분포를 정의합니다. (`model_noise`, `uniform`)
3. **Evaluation Stage (`evaluation`)**: 학습 데이터 평가 방식을 결정합니다. (`full`, `fixed_subset`)
4. **Convergence Stage (`convergence`)**: 파티클 개선 정체 여부를 감지하고 재초기화 또는 조기 종료를 수행합니다. (`none`, `particle_reset`, `early_stopping`)
5. **Refinement Stage (`refinement`)**: Swarm 탐색 종료 후 최적해 가중치 후처리 미세조정을 수행합니다. (`none`, `adam`)
사용자는 문자열 식별자를 전달하여 커스텀 및 표준 알고리즘 조합을 구성하거나, `pso.plugins` 모듈의 기반 클래스 (`MovementPlugin`, `InitializationPlugin`, `EvaluationPlugin`, `ConvergencePlugin`, `RefinementPlugin`)를 상속받아 고유한 플러그인을 확장할 수 있습니다.
---
## 무브먼트/알고리즘 매트릭스 (Method Comparison Matrix)
| 문자열 식별자 (`method`) | 분류 (Categorization) | 수식 및 핵심 알고리즘 델타 (Algorithm Delta) | 표준 기본값 (Canonical Defaults) | 비용 / 상태 (Cost & State) | 기울기 (Gradient) | 주요 DOI 및 논문 제목 | 제약사항 및 주요 특징 |
| --- | --- | --- | --- | --- | --- | --- | --- |
| `original` | 논문 기반 고전 PSO | $v_{t+1} = v_t + c_0 r_1 \odot (p_{best} - x_t) + c_1 r_2 \odot (g_{best} - x_t)$
$x_{t+1} = x_t + v_{t+1}$ | $c_0=2.0, c_1=2.0, w=1.0$
(관성 가중치 곱셈 없음) | $O(1)$ 상태
추가 메모리 없음 | 미분 무관 (No) | [10.1109/ICNN.1995.488968](https://doi.org/10.1109/ICNN.1995.488968)
*Particle Swarm Optimization* (1995) | 관성 감쇄가 없는 1995년 원본 수식. negative_swarm, mutation, velocity_limit_ratio 지원. |
| `inertia` | 논문 기반 고전 PSO | $v_{t+1} = w_t v_t + c_0 r_1 \odot (p_{best} - x_t) + c_1 r_2 \odot (g_{best} - x_t)$
($w_t$: $w_{max}$에서 $w_{min}$으로 선형 감쇄) | $c_0=2.0, c_1=2.0$
$w_{max}=0.9, w_{min}=0.4$ | $O(1)$ 상태
추가 메모리 없음 | 미분 무관 (No) | [10.1109/ICEC.1998.699146](https://doi.org/10.1109/ICEC.1998.699146)
*A Modified Particle Swarm Optimizer* (1998) | 관성 가중치 감쇄를 적용하여 국소 탐색과 전역 탐색의 균형을 도모. negative_swarm, mutation 지원. |
| `constriction` | 논문 기반 고전 PSO | $v_{t+1} = \chi \left[ v_t + c_0 r_1 \odot (p_{best} - x_t) + c_1 r_2 \odot (g_{best} - x_t) \right]$
$\chi = \frac{2}{\|2 - \phi - \sqrt{\phi^2 - 4\phi}\|}, \phi = c_0 + c_1 > 4$ | $c_0=2.05, c_1=2.05$
($\phi=4.1, \chi \approx 0.72984$) | $O(1)$ 상태
추가 메모리 없음 | 미분 무관 (No) | [10.1109/4235.985692](https://doi.org/10.1109/4235.985692)
*The Particle Swarm - Explosion, Stability, and Convergence* (2002) | 수렴 수치 안정성을 보장하는 수축 계수 $\chi$ 적용. $\phi = c_0 + c_1 > 4$ 조건 필수 검증. |
| `fips` | 논문 기반 고전 PSO | $v_{t+1} = \chi \left[ v_t + \sum_{k \in \mathcal{N}_i} \frac{U(0, \phi)}{K} \odot (p_{k,best} - x_t) \right]$
(All-to-All 토폴로지: 모든 이웃의 pbest 참조) | $\phi=4.1, \chi \approx 0.72984$
$K=N$ (전체 이웃 수) | 파티클당 $N$개 pbest 합산 연산 오버헤드 | 미분 무관 (No) | [10.1109/TEVC.2004.826074](https://doi.org/10.1109/TEVC.2004.826074)
*The Fully Informed Particle Swarm: Simpler, Maybe Better* (2004) | 전역 gbest 대신 스웜 내 모든 파티클의 pbest 정보를 가중 평산 참조. `negative_swarm` 미지원. |
| `clpso` | 논문 기반 고전 PSO | $v_{t+1,d} = w_t v_{t,d} + c r_{t,d} (p_{p_d(i),best,d} - x_{t,d})$
차원별 학습 확률 $P_{c,i}$ 및 토너먼트 선택으로 대표 샘플링 | $c=1.49445, w: 0.9 \to 0.4$
갱신 주기 $\text{gap}=7$ | 차원별 엑젬플러 할당 행렬 `[N, D]` 저장 | 미분 무관 (No) | [10.1109/TEVC.2005.857610](https://doi.org/10.1109/TEVC.2005.857610)
*Comprehensive Learning Particle Swarm Optimizer* (2006) | 각 차원마다 서로 다른 파티클의 pbest를 조합하여 다봉성(Multimodal) 탐색. `negative_swarm` 미지원. |
| `bare_bones` | 논문 기반 고전 PSO | $x_{t+1,d} \sim \mathcal{N}\left(\frac{p_{best,d} + g_{best,d}}{2}, \|p_{best,d} - g_{best,d}\|\right)$
50% 확률로 $p_{best,d}$ 직접 유지, $v=0$ 고정 | 매개변수 없음
(Parameter-free) | 속도 벡터 계산 생략 ($O(1)$ 공간) | 미분 무관 (No) | [10.1109/SIS.2003.1202251](https://doi.org/10.1109/SIS.2003.1202251)
*Bare Bones Particle Swarms* (2003) | 속도 벡터와 제어 계수를 제거하고 가우시안 확률 분포로 직접 위치 생성. `negative_swarm`, `mutation_swarm`, `velocity_limit_ratio` 미지원. |
| `local_best` | 논문 기반 고전 PSO | $v_{t+1}=w_t v_t+c_0r_1\odot(p_{best}-x_t)+c_1r_2\odot(l_{best}-x_t)$
$l_{best}$는 래핑 링 이웃의 최고 pbest | $c_0=c_1=1.49618$
$w:0.9\to0.4$, 반경 $1$ | 파티클별 링 이웃 비교; 추가 적합도 평가 없음 | 미분 무관 (No) | [10.1109/CEC.2002.1004493](https://doi.org/10.1109/CEC.2002.1004493)
*Population Structure and Particle Swarm Performance* (2002) | `method_options={"neighborhood_radius": k}`로 반경 설정. mutation 및 velocity limit 지원. |
| `quantum` | 논문 기반 고전 PSO | $m_{best}=\frac{1}{N}\sum_i p_{i,best}$
$x_{t+1}=p\pm\beta_t|m_{best}-x_t|\ln(1/u)$ | $\beta:1.0\to0.5$ | 속도 대신 직접 위치 제안; 세대별 $m_{best}$ 텐서 1개 | 미분 무관 (No) | [10.1109/CEC.2004.1330875](https://doi.org/10.1109/CEC.2004.1330875)
*Particle Swarm Optimization with Particles Having Quantum Behavior* (2004) | `negative_swarm`, `mutation_swarm`, `velocity_limit_ratio` 미지원. |
| `adaptive_moment` | 저장소 독자 실험 | $u_t$: 관성 제안 속도
$m_t, s_t$: 1차/2차 경로 모멘트 추적 및 편향 보정
$v_{final} = (1-\lambda) u_t + \lambda v_{adapt}$ | $\text{blend}=0.25, c_0=0.5, c_1=0.3$
$w_{max}=0.9, w_{min}=0.1$
$\beta_1=0.9, \beta_2=0.999, \text{step}=1.0$ | 파티클당 2개 추가 모멘트 텐서 ($m_t, s_t$) | 미분 무관 (No) | DOI 없음
*(Repository Experiment)* | 역전파 및 추가 적합도 평가 없이 인-플라이트 경로 모멘트를 혼합하는 독자 실험 수식 (기본 blend=0.25 활성화). |
---
## 기법 분류 및 방법론 명확화 (Method Categorization)
`pso2keras` 라이브러리에 포함된 기법들은 명확히 다음과 같이 3가지 범주로 분류됩니다:
### 1. 논문 기반 고전 PSO (Paper-Faithful Classical PSO Methods)
원문 논문의 수학적 수식과 이동 메커니즘을 정확히 구현한 알고리즘입니다:
- `original`: Kennedy & Eberhart (1995) 원본 1995 PSO
- `inertia`: Shi & Eberhart (1998) 관성 가중치 감쇄 PSO
- `constriction`: Clerc & Kennedy (2002) 수축 계수 PSO
- `fips`: Mendes et al. (2004) Fully Informed Particle Swarm
- `clpso`: Liang et al. (2006) Comprehensive Learning PSO
- `bare_bones`: Kennedy (2003) Bare Bones 확률형 PSO
- `local_best`: Kennedy & Mendes (2002) 링 이웃 토폴로지 local-best PSO
- `quantum`: Sun, Feng & Xu (2004) Quantum-Behaved PSO
### 2. 딥러닝 적응 기법 (Deep-Learning Adaptations)
PyTorch 고차원 매개변수 공간 최적화를 위해 도입된 실용적 플러그인 기법입니다:
- `model_noise` (Initialization): PyTorch `nn.Module` 표준 초기화 가중치에 유니폼 노이즈 스케일(`[-initial_position_noise, initial_position_noise]`)을 부가하여 스웜 파티클을 확장.
- `fixed_subset` (Evaluation): 전체 데이터셋에서 시드 기반으로 무작위 추출한 고정 서브셋으로 매 세대 파티클을 평가함으로써 Cross-batch 배치 평가 노이즈를 차단하고 공정한 pbest/gbest 수렴 점수를 비교.
- `adam` (Refinement): 하이브리드 PSO-BP (Backpropagation) 결합 연구(Zhang et al. 2007)에서 영감을 얻어, PSO 전역 최적 탐색 완료 후 전역 최적해($G_{best}$) 위치에서 PyTorch Adam 최적화기로 최종 경사하강 미세조정을 수행 (논문의 고전 SGD-BP 재현이 아닌 PyTorch 매개변수 공간 맞춤형 Adam 변형).
### 3. 저장소 독자 실험 (Repository Experiment)
- `adaptive_moment` (Movement): PSO 탐색 중 미분 역전파나 추가 적합도 순전파 평가 없이 제안 속도 벡터의 1차/2차 경로 모멘트(Path Moments)를 추적하여 혼합하는 독자적 실험 기법입니다 (선택 시 blend=0.25 기본 활성화, blend=0.0으로 비활성화 가능).
---
## 미지원 논문 기법 및 확장 계획 (Unsupported Paper Methods)
다음 기법들은 구조적 특성상 현재 5단계 순차 플러그인 아키텍처에 직접 포함되지 않으며, 스텁(Stub) 형태의 더미 옵션으로 제공하는 대신 미지원 및 향후 확장 논문 기법으로 명확히 문서화합니다:
1. **Zhan et al. APSO Elitist Learning Strategy (ELS)**:
- *이유*: 스웜 이동 단계 외에 별도의 가우시안 변이(Gaussian mutation) 전역 최적해 파티클 후보군 순전파 평가(Out-of-band candidate evaluation)를 요구하여 세대당 적합도 평가 횟수 계약을 위배함.
2. **Cooperative Subspace PSO (van den Bergh & Engelbrecht 2004)**:
- *이유*: 전체 가중치 벡터를 1차원으로 평탄화하여 평가하는 기본 아키텍처와 달리, 차원 분할 서브스페이스별 컨텍스트 벡터 분할 순전파 연산이 필요함.
3. **PSO-NAS / 하이퍼파라미터 탐색 (Neural Architecture Search)**:
- *이유*: 신경망 구조 탐색 및 외부 루프 생성 모듈로, 연속적인 flat weight-space 무브먼트 범주를 벗어남.
4. **적합도 전환형 APSO-Adam (Jiang & Han 2017)**:
- *이유*: 적합도 문턱값(Fitness Threshold) 조건에 따라 PSO 탐색 중간에 Adam 미세조정을 교대로 전환하는 구조로, PSO 탐색 완료 후 1회 수행되는 현재 5단계 순차 Refinement 플러그인 구조와 충돌함.
---
## API 레퍼런스
### Optimizer 생성자
`from pso import Optimizer` 구문을 통해 임포트합니다.
```python
Optimizer(
model: nn.Module,
loss: nn.Module,
*,
task: Literal["binary", "multiclass", "regression"],
method: str | MovementPlugin = "original",
initialization: str | InitializationPlugin = "model_noise",
evaluation: str | EvaluationPlugin = "full",
convergence: str | ConvergencePlugin = "none",
refinement: str | RefinementPlugin = "none",
method_options: dict[str, Any] | None = None,
n_particles: int = 10,
c0: float | None = None,
c1: float | None = None,
w_min: float | None = None,
w_max: float | None = None,
negative_swarm: float = 0.0,
mutation_swarm: float = 0.0,
particle_min: float | None = None,
particle_max: float | None = None,
velocity_limit_ratio: float | None = None,
boundary_strategy: Literal["clip", "reflect"] = "clip",
initial_position_noise: float = 0.05,
seed: int | None = None,
device: str | torch.device | None = None,
fitness_size: int | None = None,
convergence_patience: int = 10,
convergence_min_delta: float = 0.0001,
convergence_monitor: Literal["loss", "acc", "mse"] = "loss",
refinement_epochs: int = 0,
refinement_lr: float = 0.001,
moment_blend: float | None = None,
moment_beta1: float | None = None,
moment_beta2: float | None = None,
moment_step_size: float | None = None,
moment_epsilon: float | None = None,
)
```
| 파라미터 | 타입 | 기본값 | 설명 |
| --- | --- | --- | --- |
| `model` | `nn.Module` | **필수** | 최적화 대상 PyTorch 신경망 모델 |
| `loss` | `nn.Module` | **필수** | PyTorch 손실 함수 인스턴스 (`nn.BCEWithLogitsLoss()`, `nn.CrossEntropyLoss()`, `nn.MSELoss()`) |
| `task` | `str` | **필수** | 작업 유형 (`"binary"`, `"multiclass"`, `"regression"`) |
| `method` | `str` \| `MovementPlugin` | `"original"` | 이동 수식 플러그인 (`"original"`, `"inertia"`, `"constriction"`, `"fips"`, `"clpso"`, `"bare_bones"`, `"adaptive_moment"`, `"local_best"`, `"quantum"`) |
| `initialization` | `str` \| `InitializationPlugin` | `"model_noise"` | 파티클 초기화 플러그인 (`"model_noise"`, `"uniform"`) |
| `evaluation` | `str` \| `EvaluationPlugin` | `"full"` | 적합도 평가 플러그인 (`"full"`, `"fixed_subset"`) |
| `convergence` | `str` \| `ConvergencePlugin` | `"none"` | 수렴 제어 플러그인 (`"none"`, `"particle_reset"`, `"early_stopping"`) |
| `refinement` | `str` \| `RefinementPlugin` | `"none"` | 후처리 미세조정 플러그인 (`"none"`, `"adam"`) |
| `method_options` | `dict` \| `None` | `None` | 커스텀 무브먼트 플러그인 전용 하이퍼파라미터 딕셔너리 |
| `n_particles` | `int` | `10` | 스웜 내 파티클 개수 (>= 1) |
| `c0`, `c1` | `float` \| `None` | `None` | 인지/사회적 계수 (`None` 지정 시 선택한 `method` 논문 기본값 자동 할당. 예: `original` -> 2.0, `inertia` -> 2.0, `constriction` -> 2.05) |
| `w_min`, `w_max` | `float` \| `None` | `None` | 관성 가중치 범위 (`None` 지정 시 선택한 `method` 논문 기본값 자동 할당. 예: `original` -> 1.0, `inertia` -> 0.4~0.9) |
| `negative_swarm` | `float` | `0.0` | 역사회적 속도를 적용할 파티클 비율 [0.0, 1.0] |
| `mutation_swarm` | `float` | `0.0` | 무작위 변이 속도를 적용할 파티클 비율 [0.0, 1.0] |
| `particle_min`, `particle_max` | `float` \| `None` | `None` | 파티클 가중치 경계 최소/최대 한계값 |
| `velocity_limit_ratio` | `float` \| `None` | `None` | 성분별 최대 속도 비율 (`(0.0, 1.0]`). `particle_min`, `particle_max` 지정 필요 |
| `boundary_strategy` | `str` | `"clip"` | 경계 이탈 처리 전략 (`"clip"`, `"reflect"`) |
| `initial_position_noise` | `float` | `0.05` | 파티클 초기 위치 노이즈 스케일 |
| `seed` | `int` \| `None` | `None` | 난수 생성 시드 |
| `device` | `str` \| `device` \| `None` | `None` | 연산 디바이스 (`None` 시 `mps` -> `cuda` -> `cpu` 자동 선택) |
| `fitness_size` | `int` \| `None` | `None` | `evaluation="fixed_subset"` 선택 시 세대별 고정 샘플링 서브셋 크기 |
| `convergence_patience` | `int` | `10` | `convergence="particle_reset"` 또는 `"early_stopping"` 시 대기 세대 수 |
| `convergence_min_delta` | `float` | `0.0001` | 정체 판단 최소 개선 지표 기준값 |
| `convergence_monitor` | `str` | `"loss"` | 정체 모니터링 지표 (`"loss"`, `"acc"`, `"mse"`) |
| `refinement_epochs` | `int` | `0` | `refinement="adam"` 선택 시 후처리 미세조정 에포크 수 |
| `refinement_lr` | `float` | `0.001` | `refinement="adam"` 선택 시 후처리 미세조정 학습률 |
| `moment_blend` | `float` \| `None` | `None` | `method="adaptive_moment"` 모멘트 혼합 비율 (`None` 지정 시 `adaptive_moment` 기본값 `0.25` 할당) |
| `moment_beta1` | `float` \| `None` | `None` | `adaptive_moment` 1차 모멘트 감쇄 계수 (`None` 지정 시 기본값 `0.9`) |
| `moment_beta2` | `float` \| `None` | `None` | `adaptive_moment` 2차 모멘트 감쇄 계수 (`None` 지정 시 기본값 `0.999`) |
| `moment_step_size` | `float` \| `None` | `None` | `adaptive_moment` 모멘트 스텝 스케일 (`None` 지정 시 기본값 `1.0`) |
| `moment_epsilon` | `float` \| `None` | `None` | `adaptive_moment` 수치 안정성 상수 (`None` 지정 시 기본값 `1e-8`) |
> **검증 예외 규약**:
> - `fitness_size` 파라미터는 `evaluation="fixed_subset"` 선택 시에만 허용되며, `evaluation="full"`에서 사용 시 `ValueError`가 발생합니다.
> - `refinement_epochs > 0` 설정은 `refinement="adam"` 선택 시에만 허용됩니다.
> - `method="quantum"`은 직접 위치를 제안하므로 `negative_swarm`, `mutation_swarm`, `velocity_limit_ratio`와 함께 사용할 수 없습니다.
> **파라미터 우선순위 (Execution Parameter Precedence)**:
> `Optimizer` 생성 시 지정된 실행 파라미터(`fitness_size`, `refinement_epochs`, `refinement_lr` 등)는 생성자 기본값으로 보관되며, `fit()` 메서드 호출 시 직접 전달된 매개변수가 생성자 기본값을 우선하여 재정의(Override)한 후 해당 실행 컨텍스트에 최종 적용됩니다.
---
### fit 메서드
```python
def fit(
self,
x: torch.Tensor,
y: torch.Tensor,
*,
epochs: int = 10,
batch_size: int | None = None,
fitness_size: int | None = None,
renewal: Literal["acc", "loss", "mse"] = "acc",
refinement_epochs: int = 0,
refinement_lr: float = 0.001,
validation_data: tuple[torch.Tensor, torch.Tensor] | None = None,
validation_split: float | None = None,
output_dir: str | os.PathLike | None = None,
log_format: Literal["none", "csv", "tensorboard"] = "none",
checkpoint_interval: int | None = None,
save_info: bool = False,
) -> tuple[float, float, float]:
...
```
---
### 적응형 모멘트 PSO (Adaptive Moment PSO - 저장소 독자 실험)
`method="adaptive_moment"`는 스웜 제안 속도 벡터의 1차/2차 경로 모멘트(Path Moments)를 추적하여 속도를 적응 조정하는 미분 무관 저장소 독자 실험 기법입니다:
$$m_t = \beta_1 m_{t-1} + (1 - \beta_1) u_t, \quad s_t = \beta_2 s_{t-1} + (1 - \beta_2) u_t^2$$
$$\hat{m}_t = \frac{m_t}{1 - \beta_1^t}, \quad \hat{s}_t = \frac{s_t}{1 - \beta_2^t}$$
$$v_{adapt} = \text{step\_size} \times \sqrt{\text{mean}(\hat{s}_t)} \times \frac{\hat{m}_t}{\sqrt{\hat{s}_t} + \epsilon}$$
$$v_{final} = (1 - \lambda) u_t + \lambda v_{adapt} \quad (\lambda = \text{moment\_blend})$$
- `method="adaptive_moment"` 문자열 식별자를 지정하거나 `AdaptiveMomentMovement` 플러그인을 선택하면 `moment_blend` 기본값이 `0.25`로 결정되어 파티클별 1차/2차 경로 모멘트 텐서($m_t, s_t$)가 메모리에 할당 및 추적됩니다. 반면 비적응형(Nonadaptive) 기법들(`original`, `inertia`, `constriction`, `fips`, `clpso`, `bare_bones`, `local_best`, `quantum`)을 선택하거나 `moment_blend = 0.0`으로 명시적 설정할 경우 경로 모멘트 텐서를 전혀 할당하지 않아 메모리를 보존합니다.
- 고차원 및 복잡한 목적함수 연산 시 다양성은 증대되나 검증 손실/캘리브레이션 악화가 발생할 수 있으므로 문제별 선택적 옵트인(Opt-in)이 요구됩니다.
---
### 하이브리드 Adam 미세조정 (Hybrid Refinement)
`refinement="adam"` 및 `refinement_epochs > 0` 선택 시, PSO 탐색으로 도출된 전역 최적해($G_{best}$) 파라미터 위치를 초기점으로 지정하여 PyTorch Adam 최적화기(`torch.optim.Adam`)로 최종 경사하강 미세조정을 수행합니다:
1. **동일 적합도 데이터 분할**: `evaluation="fixed_subset"`이 활성화된 경우, Adam 미세조정도 PSO 탐색 단계에서 샘플링되어 유지된 동일한 고정 서브셋(`fixed_subset`)을 사용하여 미세조정 및 손실 평가를 수행합니다.
2. **`eval()` 모드 유지**: 미세조정 중에도 모델은 `eval()` 모드를 유지하여 드롭아웃 및 배치 정규화 계수 변동을 차단합니다.
3. **가중치 바운드 클램핑**: 매 Adam step 직후 `particle_min`, `particle_max` 경계로 파라미터를 즉시 클램핑합니다.
4. **엄격한 수용 조건**: Adam 미세조정 결과가 기존 $G_{best}$ 스코어를 엄격히 향상시킨 경우에만 최종 점수 및 가중치를 반영합니다.
5. **학술 연구 대비 구현 명확화**: Zhang et al. (2007, DOI 10.1016/j.amc.2006.07.025)의 고전 하이브리드 PSO-BP 논문에서 영감을 얻었으나, 논문의 역전파(SGD-BP) 수식을 그대로 재현한 것이 아니라 PyTorch 텐서 및 매개변수 생태계에 맞추어 Adam 최적화기로 경사하강 미세조정을 수행합니다.
---
### 결과 및 평가 메서드
- `evaluate(x: torch.Tensor, y: torch.Tensor, *, batch_size: int | None = None) -> tuple[float, float, float]`: 전역 최적해 가중치($G_{best}$)로 입력 데이터 `(x, y)`에 대한 `(loss, accuracy, mse)` 점수를 직접 평가하여 반환합니다. 옵티마이저 내부 상태를 변경하지 않고 파일 아티팩트를 생성하지 않아 독립적인 검증 평가 및 수렴 비교 시 안전하게 활용됩니다.
- `get_best_model() -> nn.Module | None`: 최적 가중치가 반영된 새로운 `eval()` 모드 PyTorch `nn.Module` 인스턴스를 반환합니다.
- `get_best_score() -> tuple[float, float, float] | None`: 전역 최적해의 `(loss, accuracy, mse)` 튜플을 반환합니다.
- `get_best_state_dict() -> collections.OrderedDict[str, torch.Tensor] | None`: 전역 최적 가중치의 CPU 복사본 state dict를 반환합니다.
---
## 비교 CLI 도구 (Method Comparison CLI)
다양한 무브먼트 알고리즘과 플러그인 조합의 성능을 단일 CLI 명령으로 비교 평가할 수 있는 도구를 제공합니다:
```shell
# XOR 데이터셋 대상 9개 무브먼트 알고리즘 3개 시드 비교 실행
uv run python test/compare_methods.py \
--dataset xor \
--methods original inertia constriction fips clpso bare_bones adaptive_moment local_best quantum \
--seeds 42 43 44 \
--epochs 100 \
--particles 30 \
--json-path ./result/comparison_xor.json
```
주요 CLI 파라미터:
- `--dataset`: `xor`, `iris`, `mnist` 선택
- `--methods`: 비교할 무브먼트 알고리즘 목록 (`original`, `inertia`, `constriction`, `fips`, `clpso`, `bare_bones`, `adaptive_moment`, `local_best`, `quantum`)
- `--initialization`: `model_noise`, `uniform`
- `--evaluation`: `full`, `fixed_subset`
- `--convergence`: `none`, `particle_reset`, `early_stopping`
- `--refinement`: `none`, `adam`
- `--seeds`: 평가에 사용할 정수 시드 목록
- `--json-path`, `--output-json`, `--json`: 비교 결과 집계 JSON 파일 저장 경로 (동일한 인자의 별칭 지원)
알고리즘 수렴 성능 비교 시 `Optimizer.evaluate()` 메서드를 통해 동일한 데이터 평가 규약으로 `(loss, accuracy, mse)` 점수를 계산하여 아티팩트로 저장합니다.
---
## 실전 튜닝 및 벤치마크 (Tuning & Benchmark Results)
> **※ 성능 측정 조건 알림**:
> 아래 측정 결과는 구버전 튜닝 프로필 및 Benchmark Protocol 2.0.0 다중 시드 실증 보고서로 구분됩니다. PSO는 모든 문제에 만능인 보편적 성능을 제공하지 않으며 데이터셋 특성에 따른 튜닝이 필수적입니다.
### PSO v4 다중 시드 실증 보고서 (Multi-Seed Empirical Report)
v4.0.0 5단계 플러그인 아키텍처 기반의 종합 실증 평가 결과입니다. 벤치마크 프로토콜 v2.0.0에 따라 총 225회의 독립 측정(메인 벤치마크 7기법 × 5워크로드 × 5시드 = 175회, MNIST Ablation 10프로필 × 5시드 = 50회)을 수행하였으며, 모든 실행이 100% 성공적으로 완료되었습니다.
- **상세 벤치마크 보고서**: [`REPORT.md`](REPORT.md)
- **원천 측정 아티팩트**:
- 원시 JSON 데이터: [`benchmark_results/pso_v4_benchmark.json`](benchmark_results/pso_v4_benchmark.json)
- 메인 벤치마크 CSV: [`benchmark_results/pso_v4_main_benchmark.csv`](benchmark_results/pso_v4_main_benchmark.csv)
- Ablation 벤치마크 CSV: [`benchmark_results/pso_v4_ablation_benchmark.csv`](benchmark_results/pso_v4_ablation_benchmark.csv)
- **전체 재현 실행 명령**:
```shell
uv run --locked --extra examples python test/benchmark_suite.py --device mps
```
#### 메인 벤치마크 평균 순위 매트릭스 ($n=5$)
각 워크로드에서 5개 시드의 평균 지표로 1위부터 7위까지 순위를 정한 뒤, 그 순위를 5개 워크로드에 걸쳐 평균한 결과입니다.
| 기법 (`method`) | 평균 정확도 순위 | 평균 손실 순위 | 비고 |
| --- | --- | --- | --- |
| `constriction` | **1.60** | **1.60** | 수축 계수 PSO (5개 워크로드 종합 최저 평균 순위) |
| `inertia` | **1.60** | **1.80** | 관성 가중치 감쇄 PSO (정확도 순위 constriction과 공동 1위) |
| `adaptive_moment` (AM) | **3.60** | **3.60** | 경로 모멘트 추적 (독자 미분 무관 실험 기법) |
| `bare_bones` (bare) | **4.80** | **4.60** | Bare Bones 가우시안 확률 분포 PSO |
| `original` | **5.00** | **5.40** | 1995 Kennedy & Eberhart 기본 PSO |
| `fips` (FIPS) | **5.20** | **5.00** | Fully Informed Particle Swarm (전체 이웃 pbest 합산) |
| `clpso` (CLPSO) | **6.20** | **6.00** | Comprehensive Learning PSO (차원별 엑젬플러 토너먼트) |
#### 벤치마크 시각화 차트 및 Ablation 연구
| 메인 벤치마크 순위 히트맵 | MNIST 10-Profile Ablation 비교 |
| --- | --- |
| 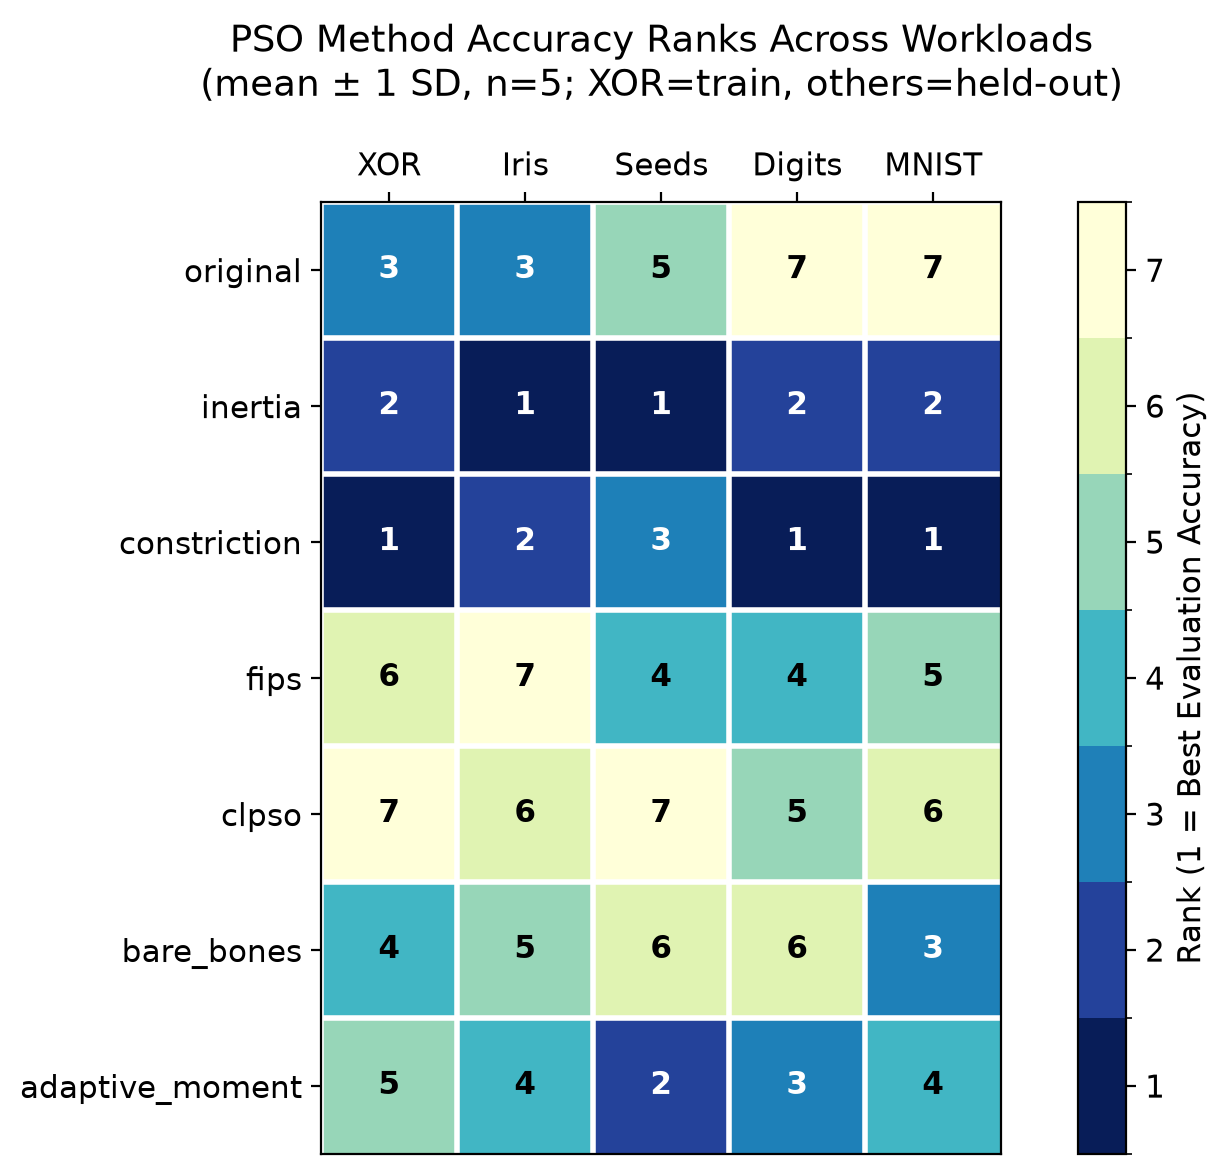 | 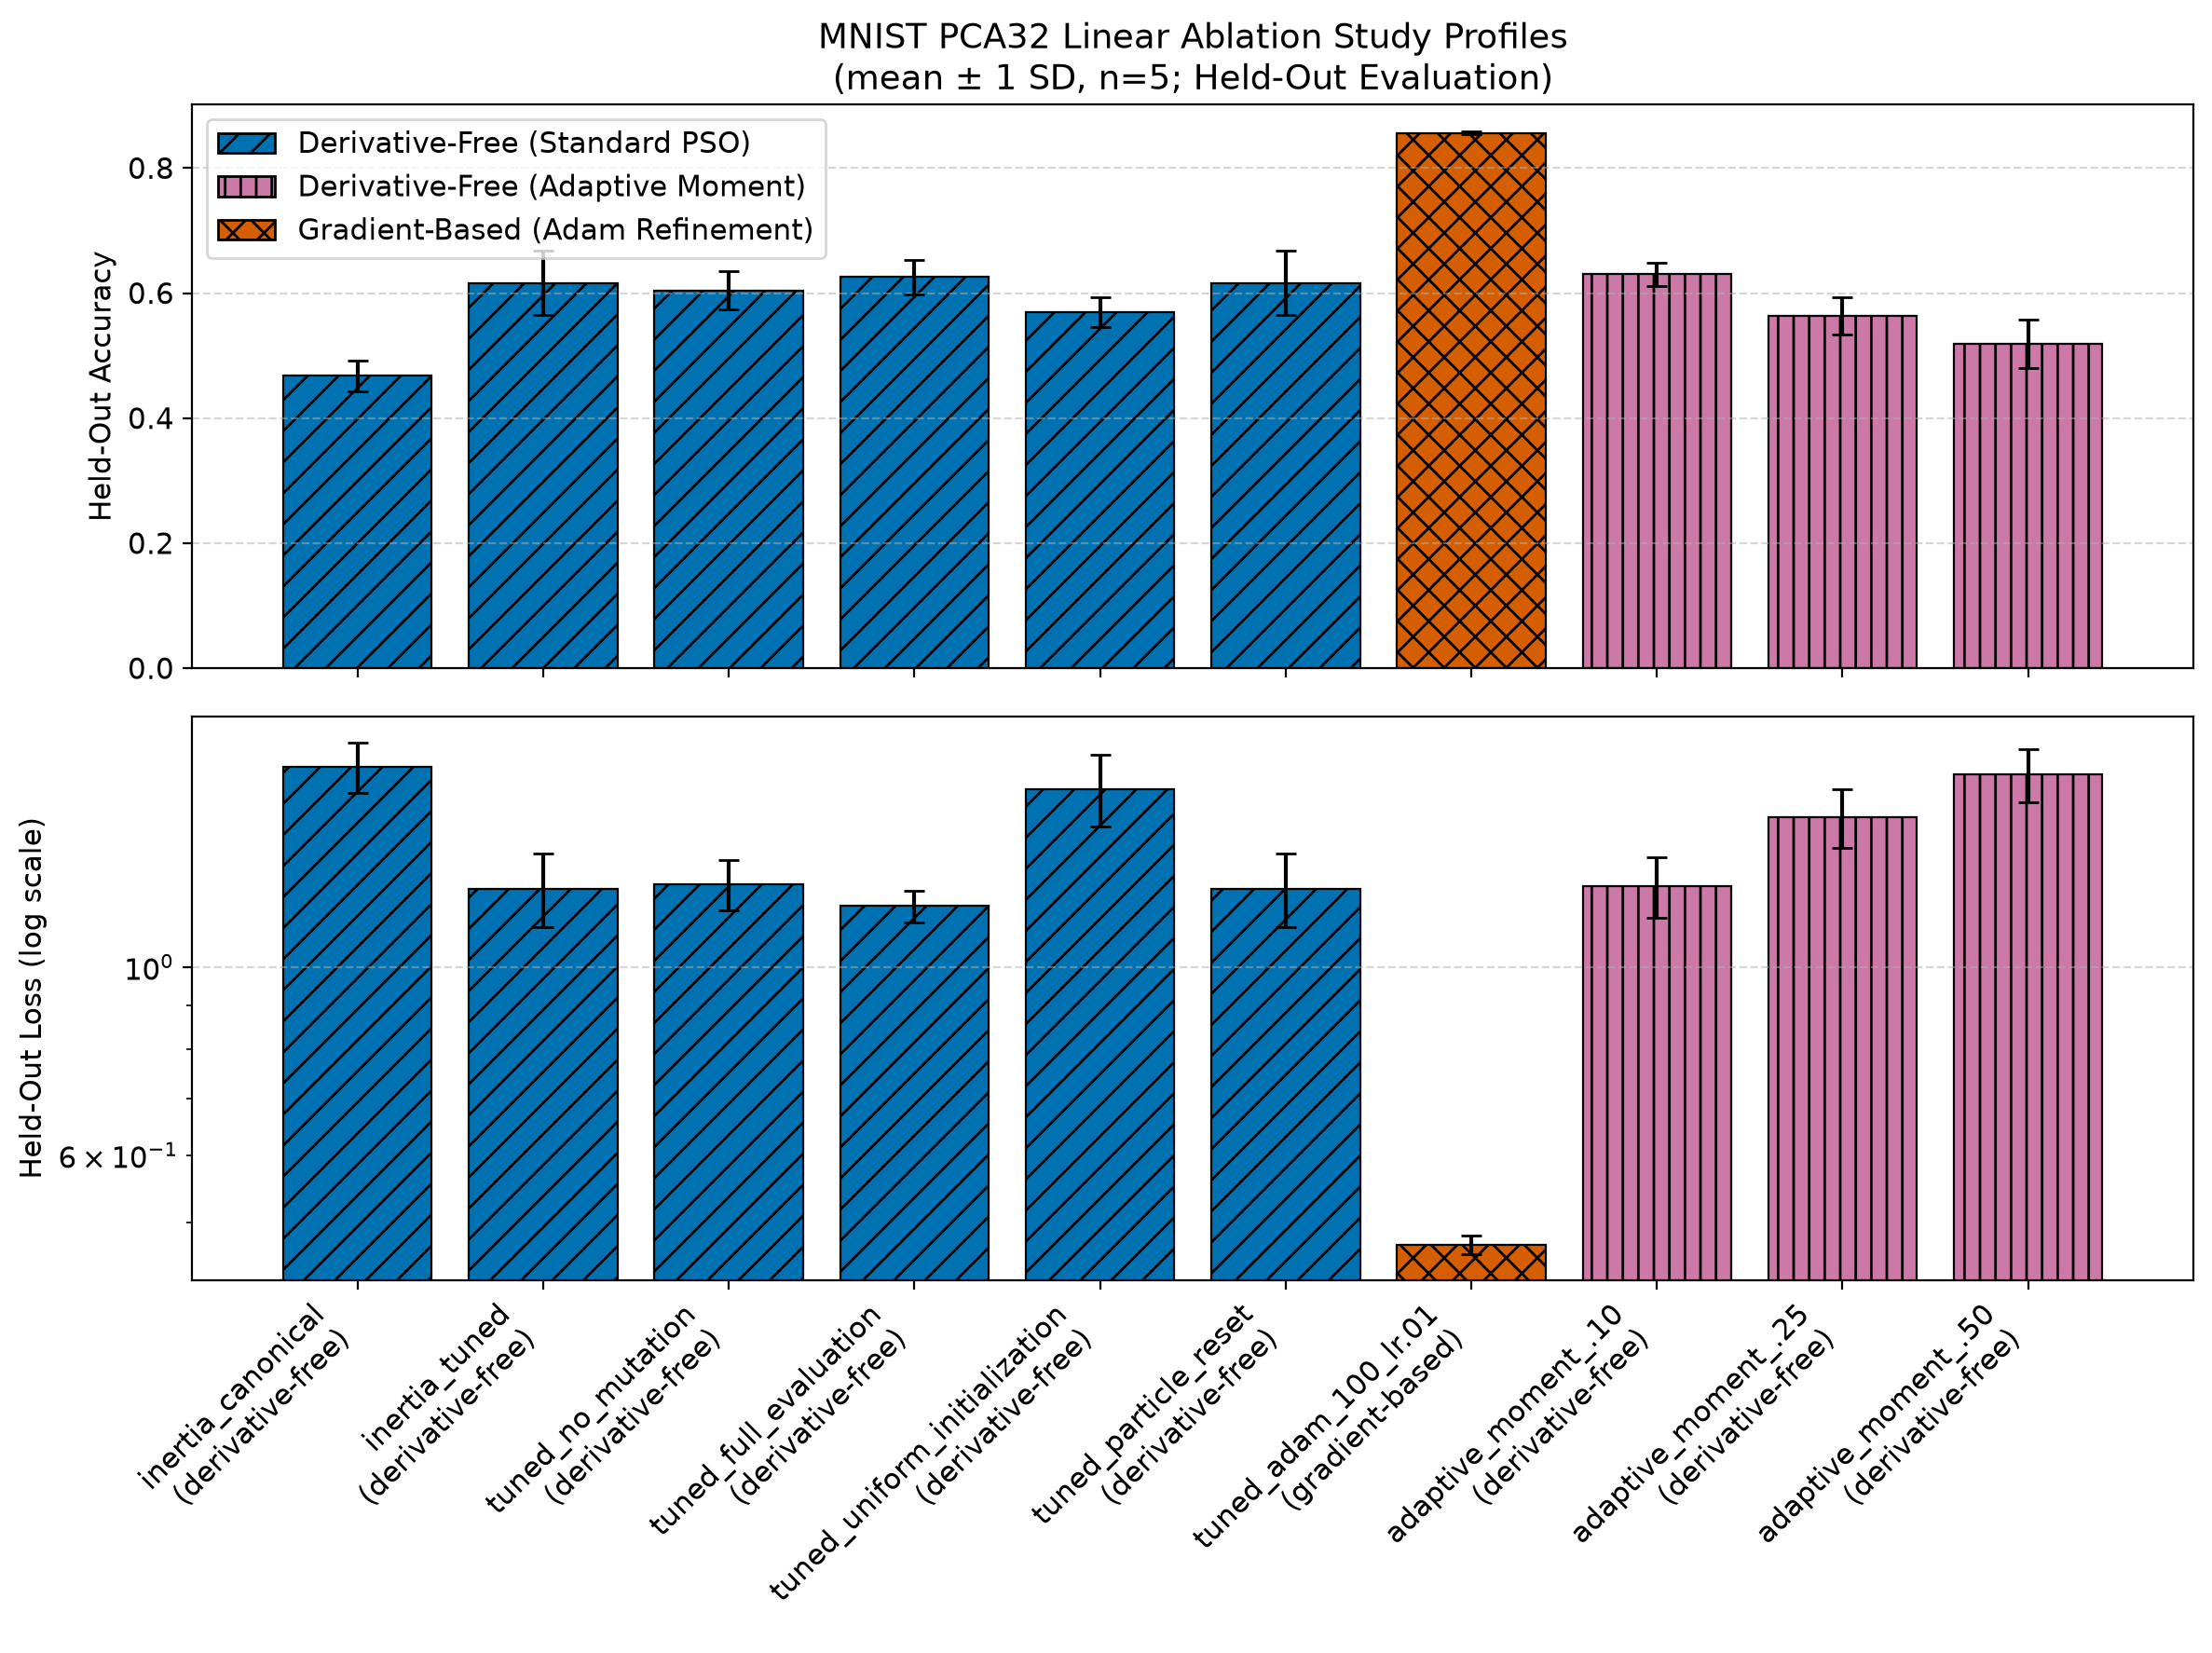 |
| *그림 1: 5개 워크로드, 시드 5개($n=5$) 평균 성능 순위 히트맵* | *그림 2: MNIST PCA32 10개 프로필 Ablation 수렴 비교 ($n=5$)* |
> **핵심 실증 관찰사항 (Grounded Findings)**:
> 1. **고전 무브먼트 기법의 낮은 평균 순위**: 5개 워크로드 종합 평균 순위에서 `constriction`과 `inertia`가 평균 정확도 순위 **1.60**으로 공동 1위를 기록하였으며, 손실 측면에서는 `constriction` (**1.60**)이 `inertia` (**1.80**) 대비 약간 더 낮은 손실 수렴 경향을 보였습니다.
> 2. **미분 무관 Ablation 최고 성과**: pure derivative-free 기법 중 MNIST Ablation 최고 검증 정확도는 `adaptive_moment_.10` (경로 모멘트 혼합비 $\lambda=0.10$)으로 **63.00% ± 1.83%**를 기록했습니다 (단, 검증 손실은 **1.243339**로 `inertia_tuned`의 **1.236600** 대비 약간 높음).
> 3. **경사도 기반 Adam 하이브리드 미세조정 구별**: `tuned_adam_100_lr.01` 프로필은 검증 정확도 **85.58% ± 0.24%**로 전체 10개 프로필 중 최고 성과를 달성했으나, 이는 역전파 경사도(`loss.backward()`)를 활용하는 하이브리드 Adam 미세조정이 적용된 것으로 순수 미분 무관(Derivative-Free) PSO 탐색과 구별됩니다.
> 4. **해석상 유의사항**: 위 순위 및 성과는 5개 특정 워크로드 및 고정 예산에서의 표본 평가 결과이며, 보편적 우위(Universal Best)나 통계적 유의성을 주장하지 않습니다.
### 확장 튜닝 및 파티클 스케일링 (Extended Tuning & Particle Scaling)
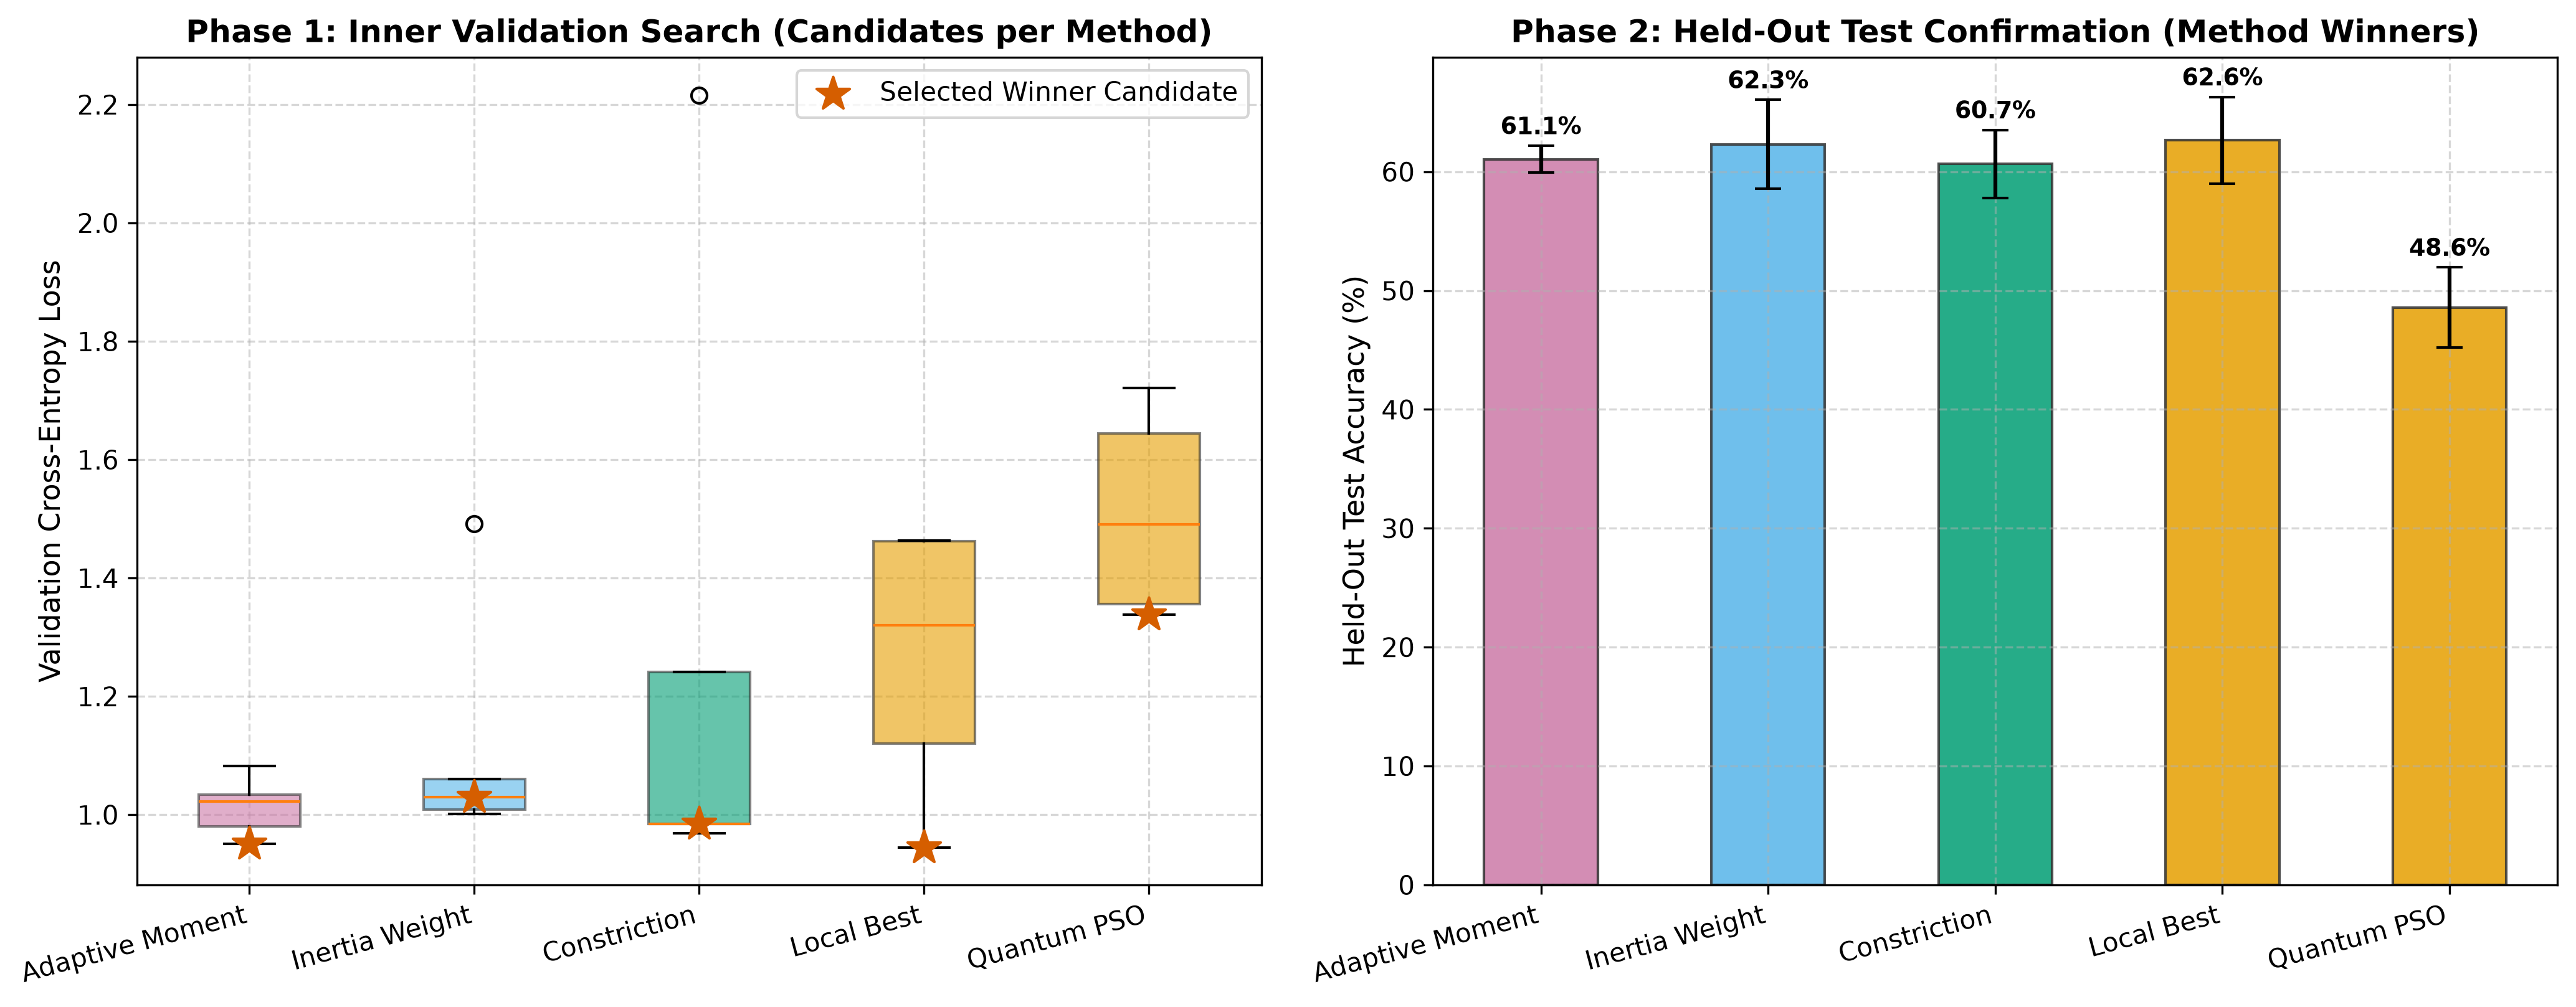
기존 Protocol 2.0.0 결과와 별도로 Tuning Protocol 1.0.0을 실행했습니다. MNIST 첫 3,000개 학습 샘플에서 2,400/600 stratified inner split을 만들고 inner-train에만 PCA32 whitening을 적합하여 32개 후보를 시드 51~53으로 선택했습니다. 이후 선택된 각 기법의 후보를 전체 3,000개 학습 데이터로 다시 적합하고, 탐색에 사용하지 않은 1,000개 테스트 샘플에서 시드 61~65로 확인했습니다. 모든 비교는 미분 무관, 파티클 30개, 80세대 조건입니다.
| 기법 | 검증 선택 후보 | Held-out 테스트 정확도 | Held-out 테스트 손실 | Fit 시간 |
| --- | --- | ---: | ---: | ---: |
| `local_best` | `local_best_r4_constant` | **62.64% ± 2.94%** | **1.211368 ± 0.059575** | 2.512s ± 0.048s |
| `inertia` | `inertia_asymmetric` | 62.30% ± 3.01% | 1.212971 ± 0.078548 | 2.570s ± 0.035s |
| `adaptive_moment` | `am_b0.06_s0.5` | 61.06% ± 0.91% | 1.229627 ± 0.022179 | 2.943s ± 0.256s |
| `constriction` | `constriction_c205_canonical` | 60.66% ± 2.30% | 1.246275 ± 0.044657 | 2.521s ± 0.045s |
| `quantum` | `quantum_beta_0.4_0.9` | 48.58% ± 2.71% | 1.519246 ± 0.052511 | 2.403s ± 0.022s |
따라서 이 동일 예산 확인에서는 `adaptive_moment`가 최상위가 아니며, `local_best`와 `inertia`가 더 높은 평균 정확도를 기록했습니다. 표본 수는 $n=5$이므로 통계적 유의성이나 보편적 우위를 주장하지 않습니다.
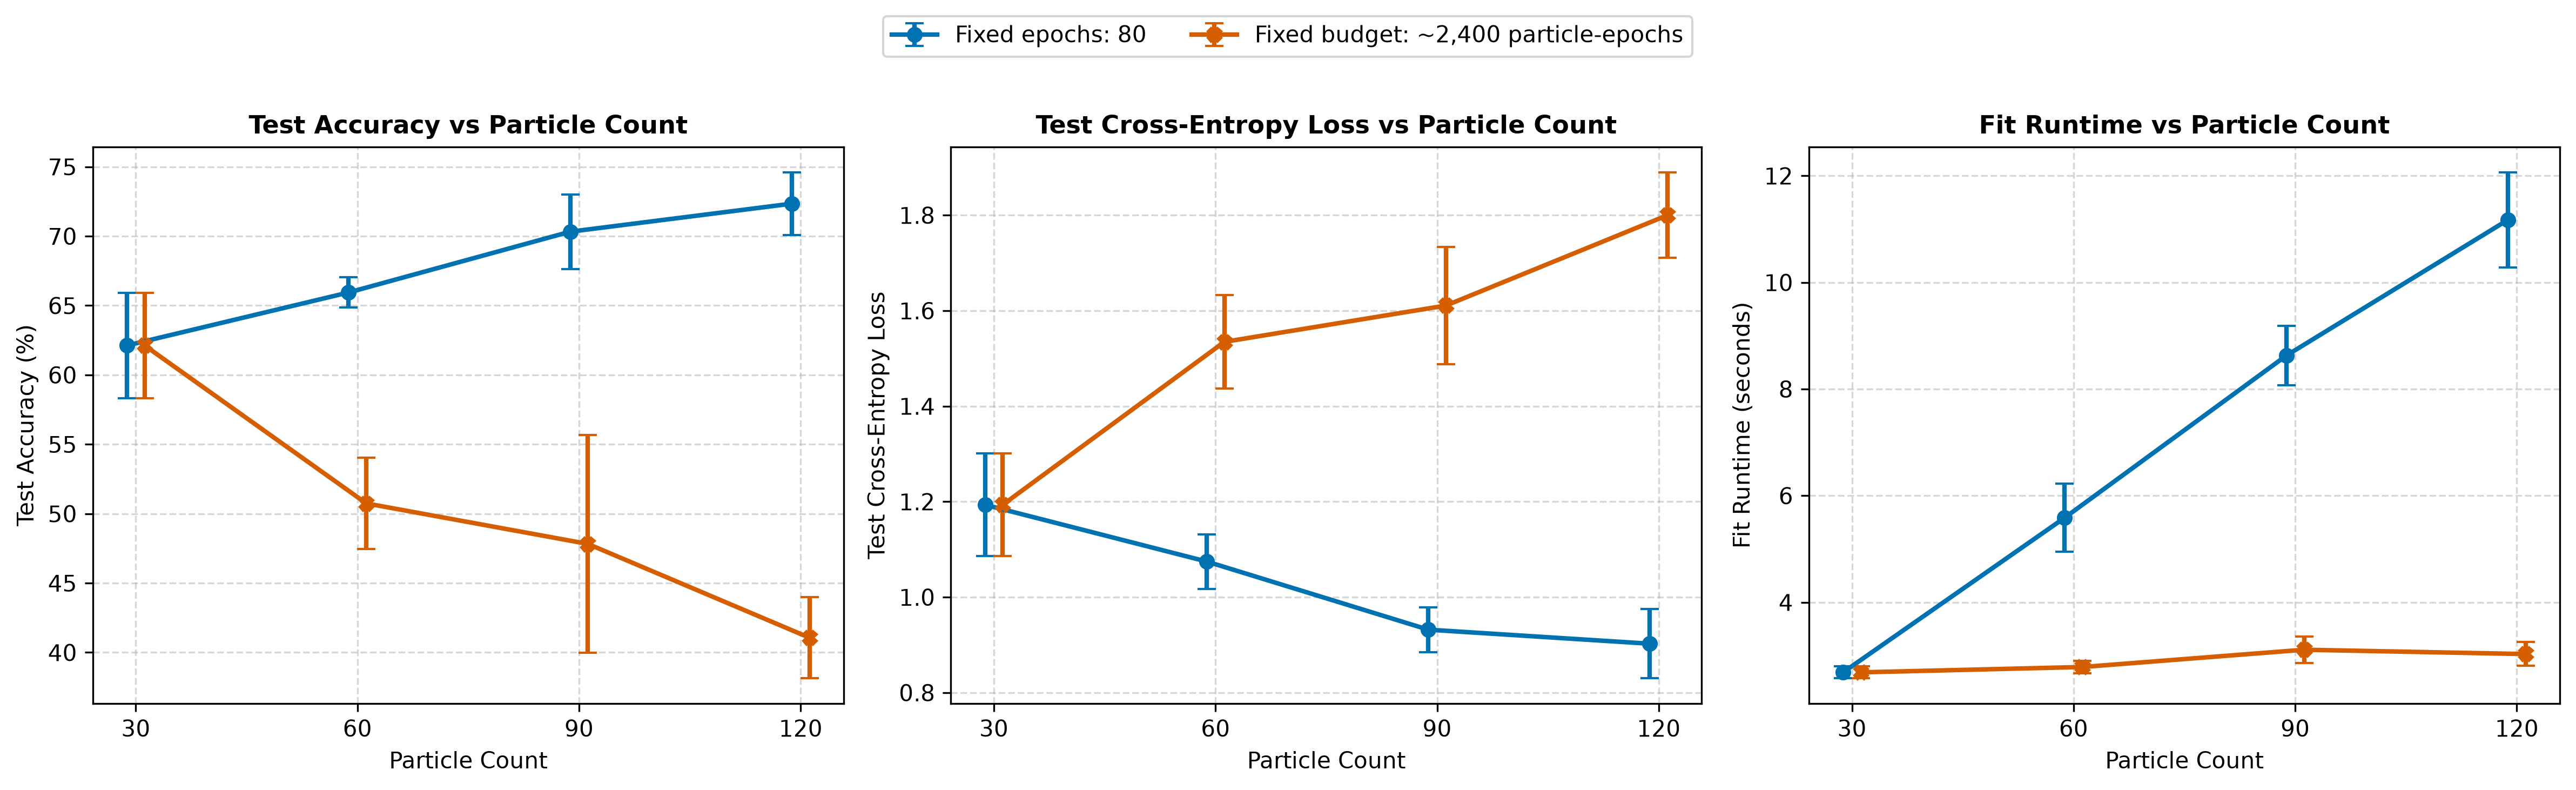
선택된 `adaptive_moment` 후보를 시드 71~75에서 파티클 수별로 추가 측정한 결과입니다:
| 비교 방식 | 파티클 | 세대 | Particle-epochs | 테스트 정확도 | 테스트 손실 | Fit 시간 |
| --- | ---: | ---: | ---: | ---: | ---: | ---: |
| Fixed epochs | 30 | 80 | 2,400 | 62.12% ± 3.07% | 1.193469 ± 0.086618 | 2.685s ± 0.090s |
| Fixed epochs | 60 | 80 | 4,800 | 65.94% ± 0.87% | 1.074629 ± 0.046106 | 5.586s ± 0.517s |
| Fixed epochs | 90 | 80 | 7,200 | 70.32% ± 2.16% | 0.931880 ± 0.038073 | 8.627s ± 0.448s |
| Fixed epochs | 120 | 80 | 9,600 | **72.34% ± 1.82%** | **0.902448 ± 0.058380** | 11.174s ± 0.718s |
| Fixed particle-epochs | 60 | 40 | 2,400 | 50.74% ± 2.66% | 1.534634 ± 0.078628 | 2.786s ± 0.095s |
| Fixed particle-epochs | 90 | 27 | 2,430 | 47.82% ± 6.31% | 1.610771 ± 0.098843 | 3.109s ± 0.203s |
| Fixed particle-epochs | 120 | 20 | 2,400 | 41.06% ± 2.36% | 1.800035 ± 0.072261 | 3.029s ± 0.179s |
80세대를 유지하면 120개 파티클이 30개 대비 **+10.22%p** 높았지만 particle-evaluations는 4배, fit 시간은 **4.16배**였습니다. 반대로 약 2,400 particle-epochs를 고정하면 파티클 증가로 세대가 줄어 정확도가 낮아졌습니다. 즉, 이 실험에서 파티클 증가는 총 탐색량을 함께 늘릴 때만 개선으로 이어졌습니다.
| 검증 선택 및 확인 | Adaptive Moment 파티클 스케일링 |
| --- | --- |
|  |  |
- **상세 분석**: [`REPORT.md`](REPORT.md)
- **원천 데이터**: [`pso_v4_tuning.json`](benchmark_results/pso_v4_tuning.json), [`search.csv`](benchmark_results/pso_v4_tuning_search.csv), [`confirmation.csv`](benchmark_results/pso_v4_tuning_confirmation.csv), [`particle_scaling.csv`](benchmark_results/pso_v4_particle_scaling.csv)
- **재현 수트 명령**:
```shell
uv run --locked --extra examples python test/tuning_suite.py --device mps
```
- **120p×80e 파티클 스케일링 재현성 검증 (별도 exact-replay + fresh-seed 검증)**:
- **결과**: **PASS**. 시드 71~75 exact replay는 **72.34% ± 1.82%**로 baseline과 같았고, 시드별 최대 정확도 차이는 **0.00%p**였습니다. 같은 시드의 초기 모델 fingerprint도 모두 일치했습니다.
- **독립 시드 확인**: 시드 81~85는 **73.60% ± 1.66%**였습니다. Baseline 대비 **+1.26%p**로 사전 허용 범위 ±3%p 안이며, baseline 95% t-CI **[70.08%, 74.60%]**와 fresh-seed 95% t-CI **[71.54%, 75.66%]**가 중첩됐습니다.
- **사전 선언 검증 조건**: exact-replay 시드 71~75의 시드별 테스트 정확도 최대 절대 차이 $\le 0.005$ (0.5%p)와 초기 모델 fingerprint 일치, 독립 시드 81~85 집단의 평균 정확도 절대 차이 $\le 0.03$ (3%p) 및 95% t-신뢰구간 중첩.
- **재현 검증 스크립트**: [`test/reproduce_scaling.py`](test/reproduce_scaling.py)
- **출력 아티팩트**: [`pso_v4_120p80_replication.json`](benchmark_results/pso_v4_120p80_replication.json), [`pso_v4_120p80_replication.csv`](benchmark_results/pso_v4_120p80_replication.csv)
- **재현 검증 명령**:
```shell
uv run --locked --extra examples python test/reproduce_scaling.py --device mps
```
이 검증은 동일 PCA32 데이터와 테스트셋에서의 수치 재현성 확인입니다. 새로운 데이터셋에 대한 외적 타당성 검증이나 추가 하이퍼파라미터 선택으로 해석하지 않습니다.
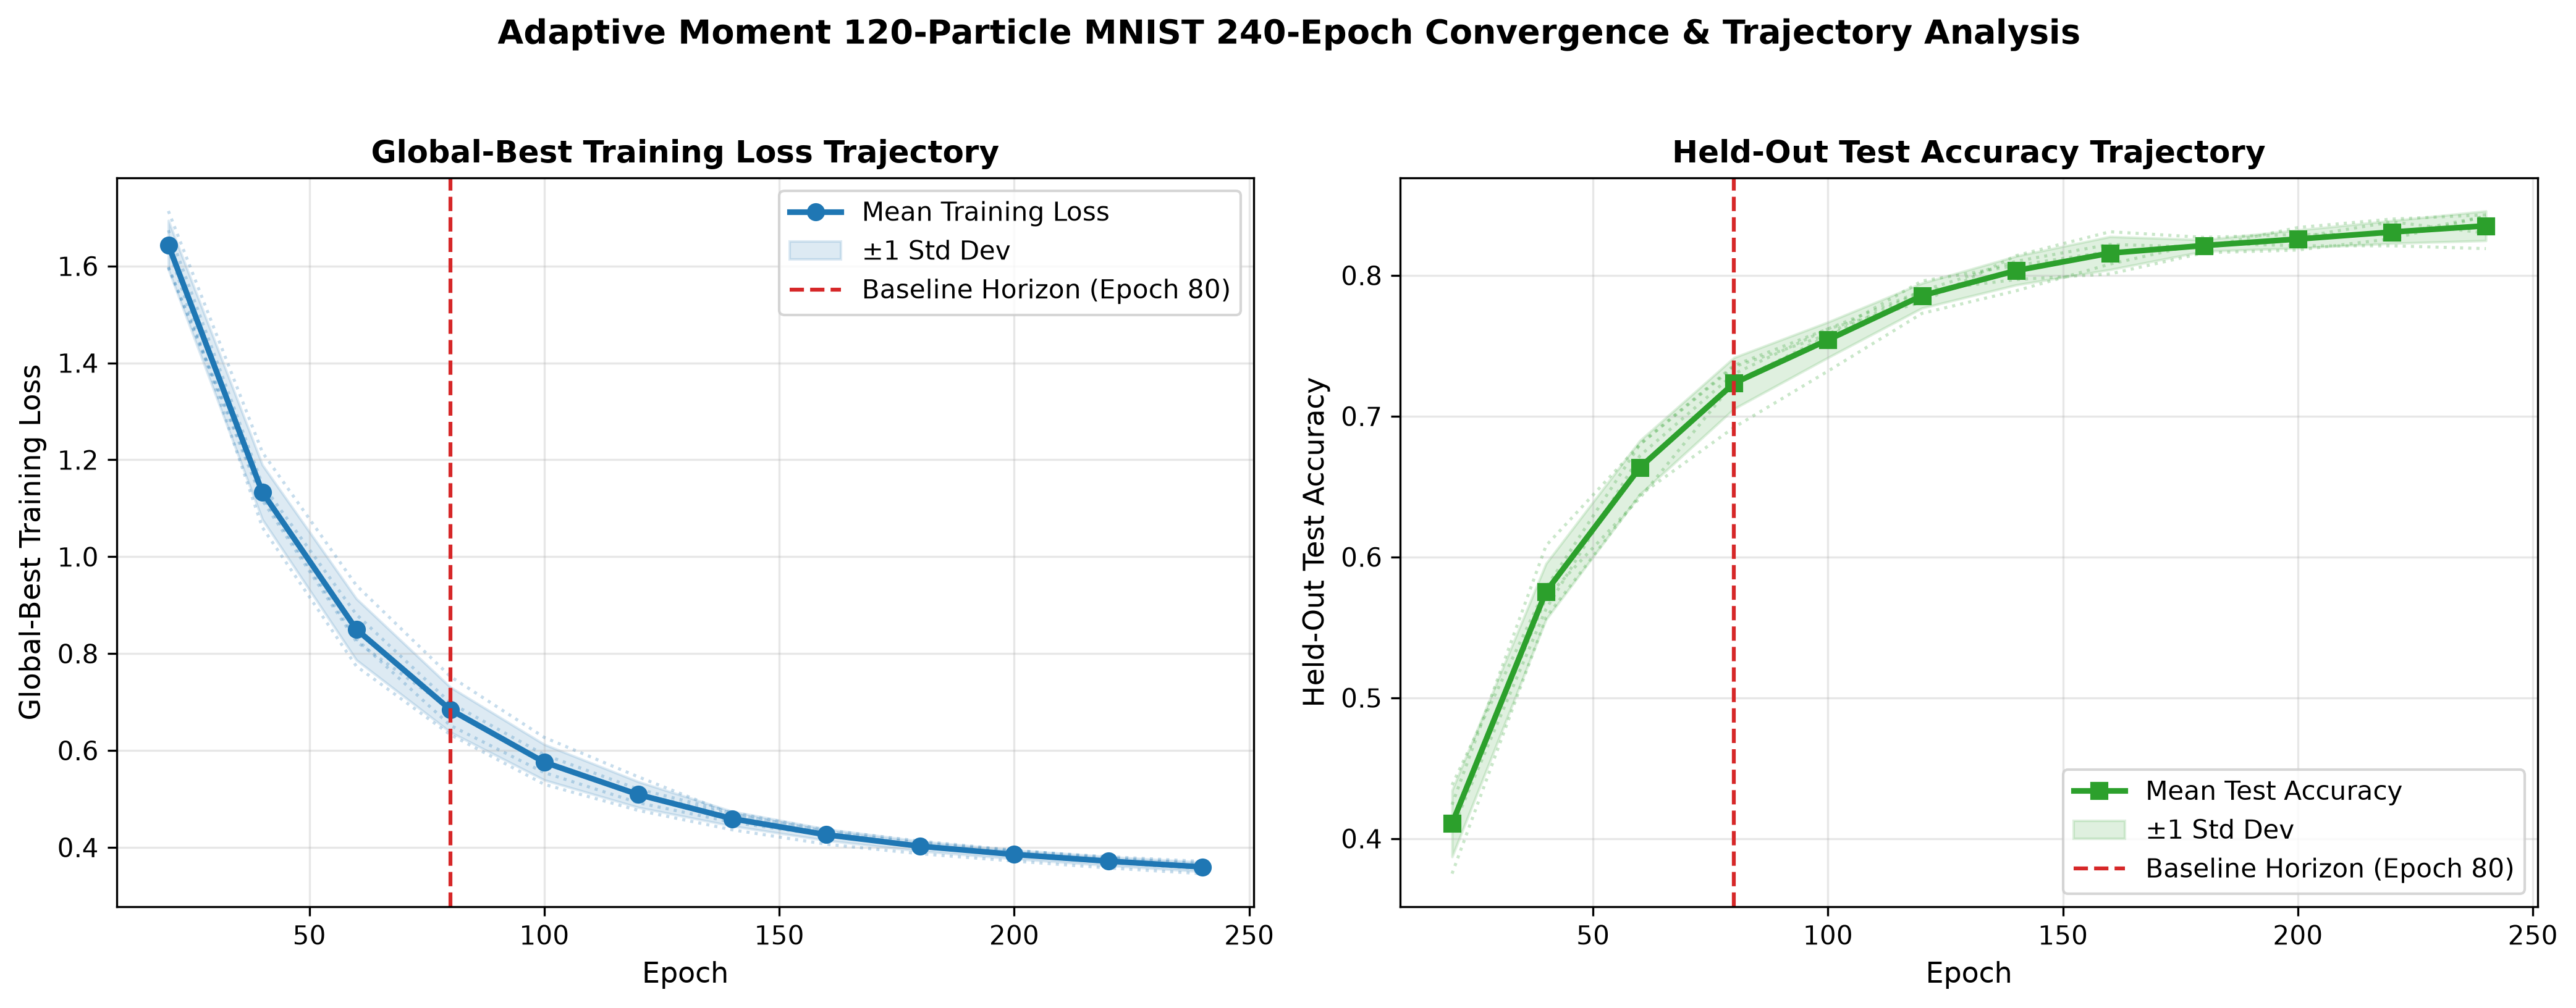
#### 120p epoch 확장 수렴 확인
동일한 `adaptive_moment` 후보와 시드 71~75를 120개 파티클로 **240세대까지 중단 없이 연속 실행**하고 20세대마다 global-best 체크포인트를 평가했습니다. Epoch 80 체크포인트는 기존 baseline과 시드별 최대 차이 **0.00%p**로 일치했습니다.
| Epoch | Particle-epochs | Training Best Loss | Test Accuracy | Test Loss |
| ---: | ---: | ---: | ---: | ---: |
| 80 | 9,600 | 0.684245 ± 0.046414 | 72.34% ± 1.82% | 0.902448 ± 0.058380 |
| 120 | 14,400 | 0.508942 ± 0.026551 | 78.56% ± 0.88% | 0.686080 ± 0.033467 |
| 160 | 19,200 | 0.426009 ± 0.011667 | 81.58% ± 1.17% | 0.599888 ± 0.027074 |
| 200 | 24,000 | 0.385320 ± 0.008996 | 82.58% ± 0.64% | 0.555652 ± 0.020276 |
| 240 | 28,800 | **0.359582 ± 0.009652** | **83.52% ± 1.05%** | **0.515820 ± 0.018827** |
Epoch 80→240에서 training best loss는 평균 **47.30%** 감소했고 테스트 정확도는 5개 시드 모두 개선되어 평균 **+11.18%p** 상승했습니다. 200→240에서도 loss가 **6.68%** 감소하고 정확도가 평균 **+0.94%p** 상승했으며, 마지막 training-best 갱신은 각 시드에서 epoch 239 또는 240에 관측됐습니다. 따라서 **epoch 80은 조기 수렴 지점이 아니며, epoch 240에서도 완전한 plateau는 확인되지 않았습니다.** 다만 세대 구간별 정확도 이득은 +6.22%p(80→120), +3.02%p(120→160), +1.00%p(160→200), +0.94%p(200→240)로 감소하여 한계효용은 줄고 있습니다.
- **실행 명령**: `uv run --locked --extra examples python test/epoch_convergence.py --device mps`
- **원천 데이터**: [`pso_v4_epoch_convergence.json`](benchmark_results/pso_v4_epoch_convergence.json), [`pso_v4_epoch_convergence.csv`](benchmark_results/pso_v4_epoch_convergence.csv)
이 checkpoint 테스트 궤적은 동일 테스트셋을 반복 관찰한 진단 자료입니다. 실제 epoch 선택이나 자동 중단 기준에는 별도 validation split과 validation metric을 사용해야 합니다.
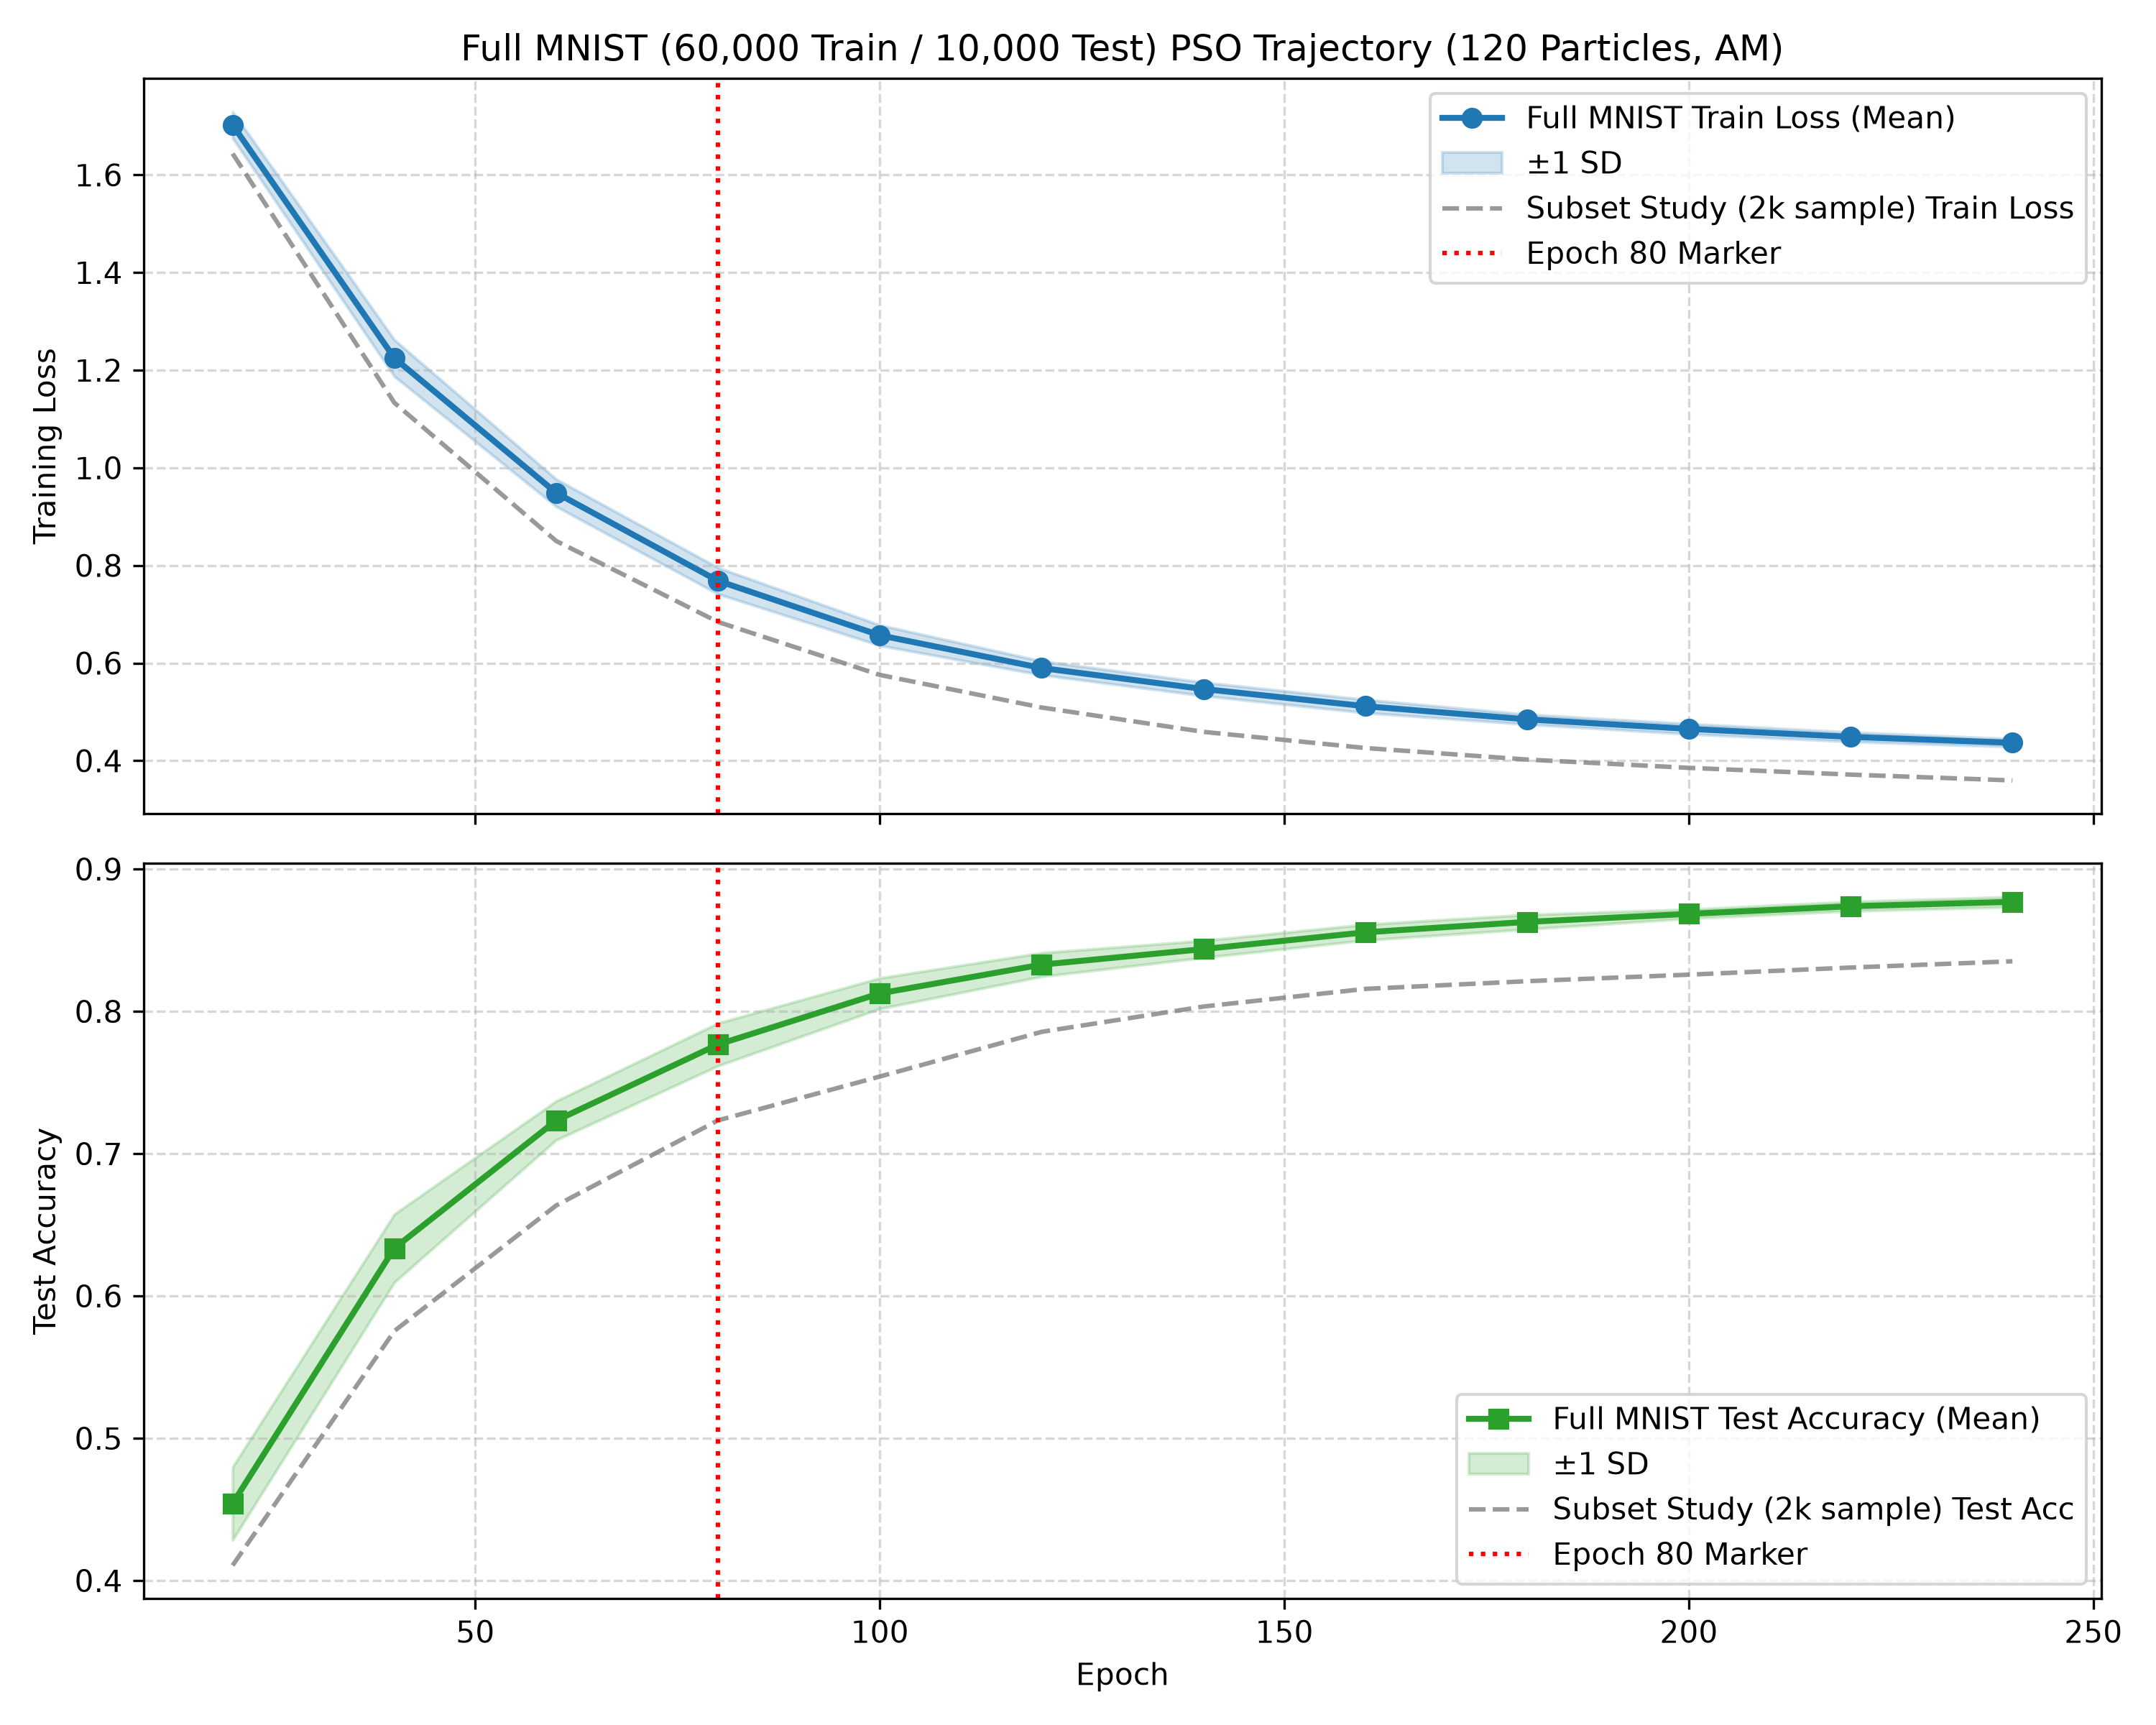
#### 전체 MNIST 60,000/10,000 학습
공식 MNIST **train 60,000개 전체**와 **test 10,000개 전체**를 사용해 별도 실행했습니다. PCA32 whitening은 train 60,000개에만 적합했고, `evaluation="full"`과 `fitness_size=None`으로 모든 파티클이 매 epoch마다 학습 60,000개 전체에서 평가됐습니다. 모델은 이전 실험과 같은 `Linear(32,10)`, 파티클 120개, 연속 240 epochs, 시드 71~75입니다.
| Epoch | Training Best Loss | Full Test Accuracy | Full Test Loss | 2k-fitness study 대비 정확도 |
| ---: | ---: | ---: | ---: | ---: |
| 80 | 0.768448 ± 0.026961 | 77.67% ± 1.50% | 0.725023 ± 0.033552 | +5.33%p |
| 120 | 0.589822 ± 0.014141 | 83.28% ± 0.83% | 0.551133 ± 0.018616 | +4.72%p |
| 160 | 0.511683 ± 0.013526 | 85.56% ± 0.56% | 0.482441 ± 0.012016 | +3.98%p |
| 200 | 0.465194 ± 0.010498 | 86.85% ± 0.32% | 0.438875 ± 0.008499 | +4.27%p |
| 240 | **0.436664 ± 0.008101** | **87.70% ± 0.36%** | **0.412078 ± 0.006848** | **+4.18%p** |
Epoch 80→240에서 테스트 정확도는 **77.67%→87.70%(+10.03%p)**, training best loss는 **43.18% 감소**했습니다. 200→240에서도 정확도가 **+0.85%p**, loss가 **6.13%** 개선됐고 5개 시드 모두 정확도가 상승했으며 마지막 training-best는 모두 epoch 240에서 갱신됐습니다. 따라서 전체 데이터 학습에서도 epoch 240 시점의 plateau는 확인되지 않았습니다.
이 실행은 5개 시드 합계 **144,000 particle-epochs**와 **86.4억 particle-sample evaluations**를 포함합니다. 2,000개 fitness subset 연구보다 모든 공통 checkpoint에서 테스트 정확도가 높았지만, PCA 적합 데이터와 fitness objective 및 RNG 소비 경로가 함께 달라지므로 위 차이는 기술적 비교이며 단일요인 인과 효과가 아닙니다.
- **실행 명령**: `uv run --locked --extra examples python test/full_mnist_study.py --device mps`
- **원천 데이터**: [`pso_v4_full_mnist.json`](benchmark_results/pso_v4_full_mnist.json), [`pso_v4_full_mnist.csv`](benchmark_results/pso_v4_full_mnist.csv)
이 결과는 전체 공식 split을 사용하지만 입력은 여전히 PCA32이고 모델은 선형 분류기입니다. 원본 784차원 PSO 또는 CNN 결과로 해석하지 않습니다. Checkpoint 테스트 궤적 역시 중단 epoch 선택이 아니라 사후 진단에만 사용합니다.
#### 공식 MNIST Deep Accuracy 프로토콜 (Deep Accuracy Protocol 1.0.0)
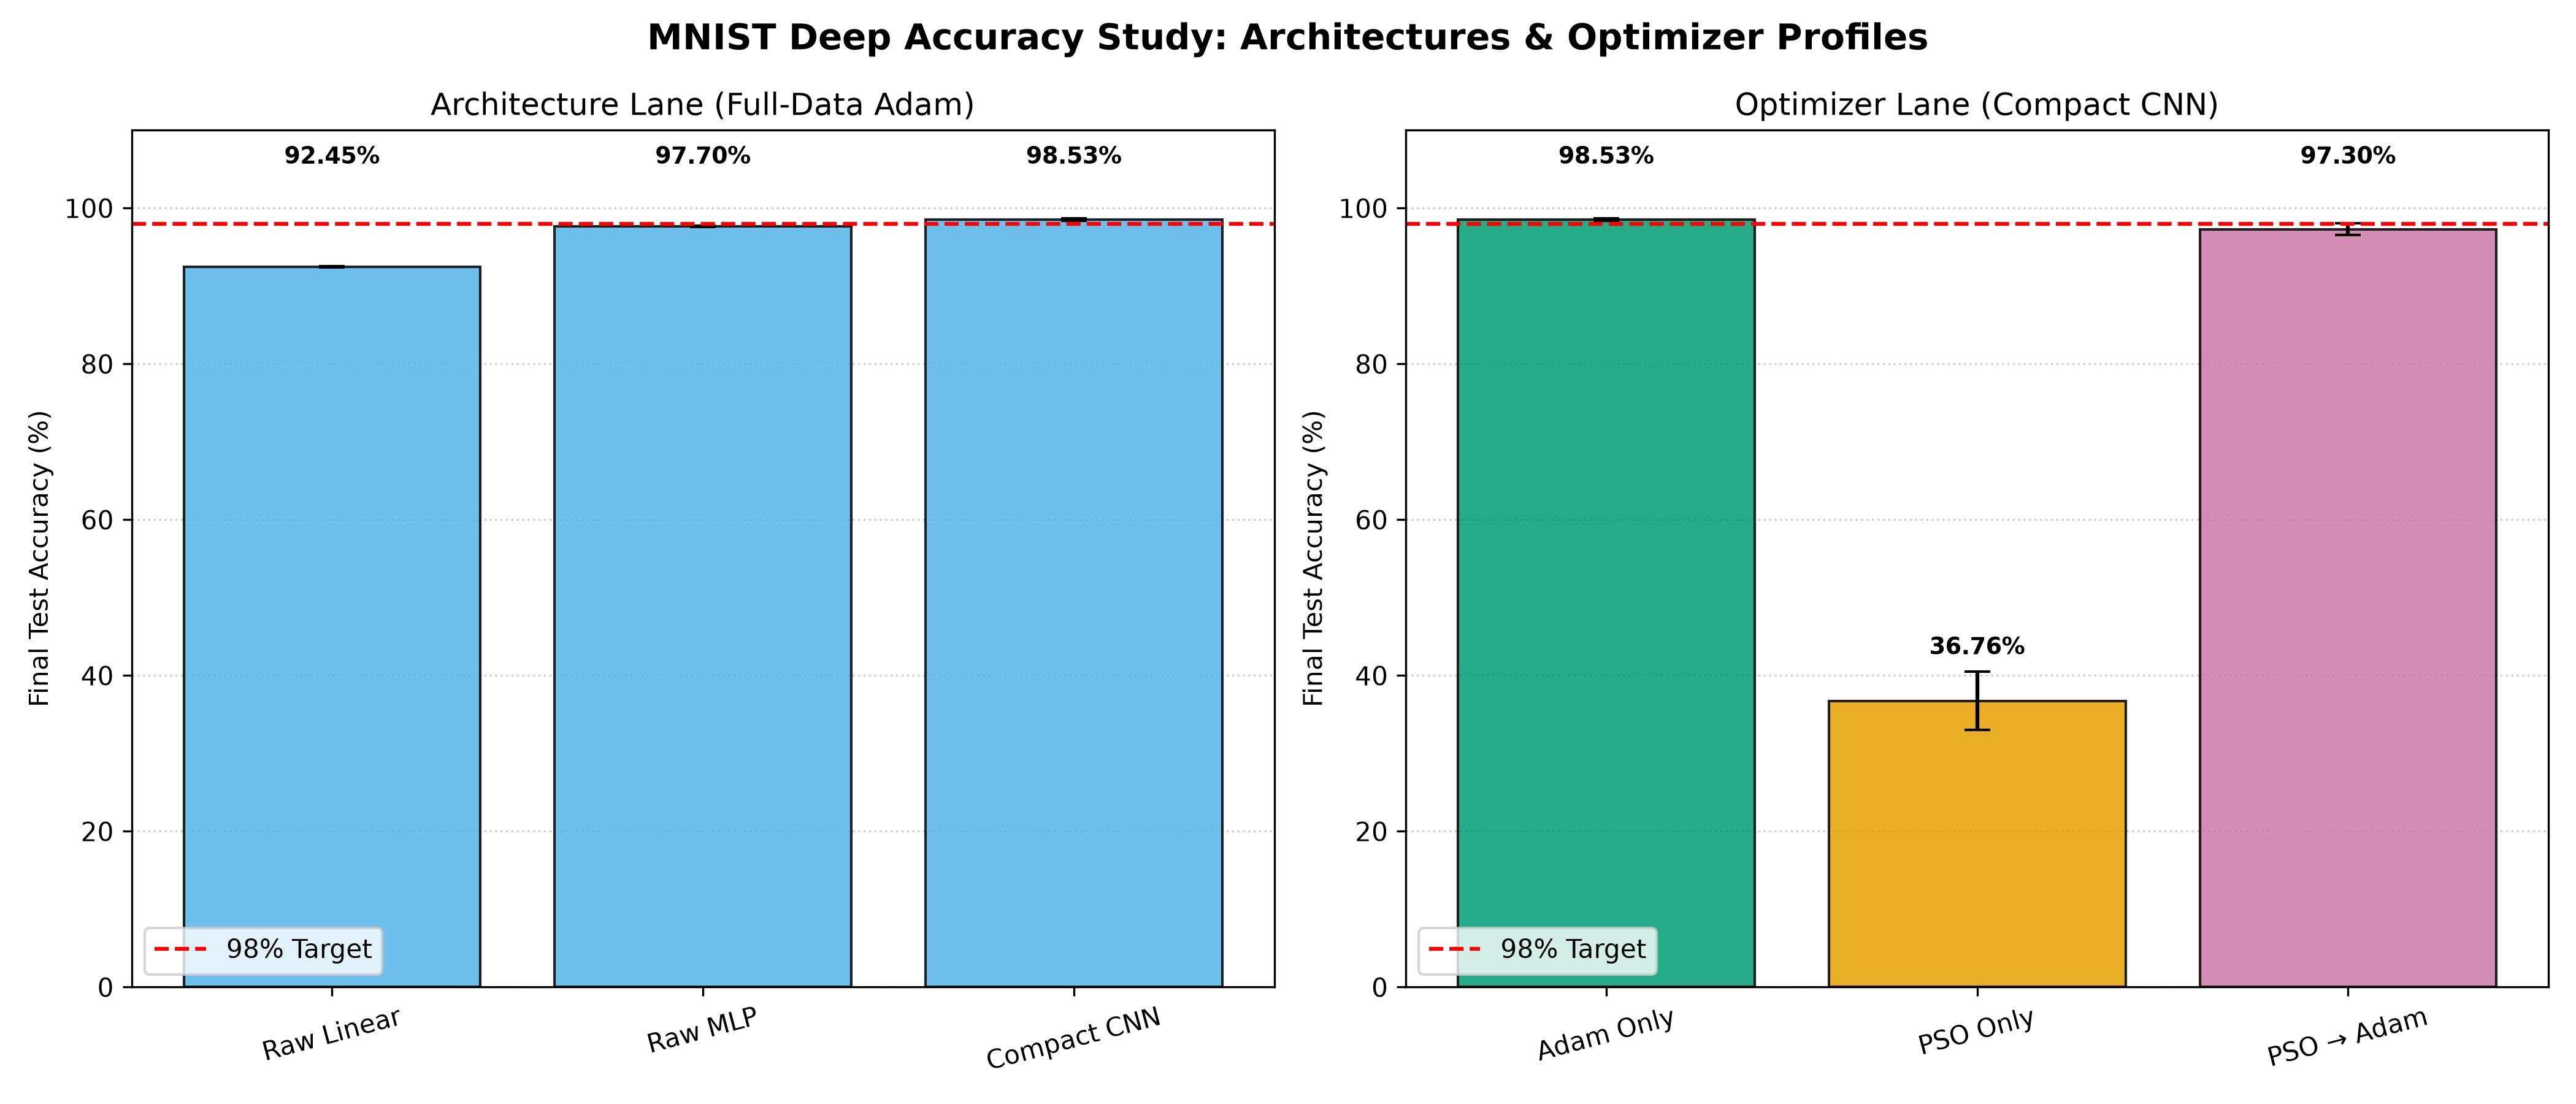
PCA 차원 축소 없이 공식 MNIST 데이터셋 전체(학습 60,000개, 테스트 10,000개) 원본 $1 \times 28 \times 28$ 입력을 대상으로 딥 신경망 아키텍처 및 최적화기 특성을 평가했습니다 (`Deep Accuracy Protocol 1.0.0`, $n=3$, seeds 101~103). 픽셀 정규화 mean(0.13066)과 std(0.308108)는 학습 60,000개에서만 산출하여 검증/테스트 데이터 누수를 차단했습니다.
본 실험은 2가지 실험 트랙(Lane)으로 구성됩니다:
1. **아키텍처 레인 (Architecture Lane)**: Adam 최적화기(10 epochs, batch 256, lr 0.001) 고정 조건에서 구조적 인덕티브 바이어스(Inductive Bias) 효과 측정.
- `raw_linear`: `Linear(784, 10)` (7,850 params)
- `raw_mlp`: `Linear(784, 128) - ReLU - Linear(128, 64) - ReLU - Linear(64, 10)` (109,386 params)
- `compact_cnn`: `Conv2d(1,8,3) - ReLU - MaxPool2d - Conv2d(8,16,3) - ReLU - MaxPool2d - Linear(784,10)` (9,098 params)
2. **최적화기 레인 (Optimizer Lane)**: 동일 `compact_cnn` (9,098 params) 모델에서 최적화 방식 비교.
- `adam_only`: Adam 10 epochs
- `pso_only`: pure all-weight PSO 40 generations (30 particles, fixed 2,000 fitness subset, 선택된 `adaptive_moment` 후보 설정)
- `hybrid`: PSO 40 generations 탐색 후 Adam 10 epochs 미세조정 (PSO 탐색 연산이 추가된 비동등 계산량 하이브리드)
##### 아키텍처 레인 성과 (Adam 10 Epochs, Mean ± Sample SD, $n=3$)
| 아키텍처 (`arch`) | 파라미터 수 | 테스트 정확도 (Mean ± SD) | 테스트 손실 (Mean ± SD) | 98% 정확도 최초 도달 |
| --- | ---: | ---: | ---: | --- |
| `raw_linear` | 7,850 | 92.45% ± 0.10% | 0.268945 ± 0.002050 | 미도달 |
| `raw_mlp` | 109,386 | 97.70% ± 0.08% | 0.078368 ± 0.002818 | 미도달 |
| `compact_cnn` | 9,098 | **98.53% ± 0.16%** | **0.043809 ± 0.004907** | **5 Epoch 이내 전 시드 달성** |
> **참고**: `compact_cnn` 아키텍처는 3개 시드 모두 5 epoch 이내에 테스트 정확도 98% 이상을 달성했습니다 (시드 101: 4 epoch, 시드 102: 3 epoch, 시드 103: 5 epoch).
##### 최적화기 레인 성과 (Compact CNN 9,098 Params, Mean ± Sample SD, $n=3$)
| 최적화 기법 (`optimizer`) | 탐색 구성 | 테스트 정확도 (Mean ± SD) | 테스트 손실 (Mean ± SD) | 비고 |
| --- | --- | ---: | ---: | --- |
| `adam_only` | Adam 10 epochs | **98.53% ± 0.16%** | **0.043809 ± 0.004907** | 역전파 경사하강법 |
| `pso_only` | PSO 40 epochs (30p × 40e) | 36.76% ± 3.76% | 14.104417 ± 8.075411 | 수렴 실패 (미분 무관 전가중치 탐색) |
| `hybrid` (PSO→Adam) | PSO 40e + Adam 10e | 97.30% ± 0.75% | 0.086542 ± 0.023969 | 추가 탐색 연산에도 pure Adam 대비 저조 |
- **실행 명령**: `uv run --locked --extra examples python test/deep_accuracy_study.py --device mps`
- **원천 데이터**: [`benchmark_results/pso_v4_deep_accuracy.json`](benchmark_results/pso_v4_deep_accuracy.json), [`benchmark_results/pso_v4_deep_accuracy.csv`](benchmark_results/pso_v4_deep_accuracy.csv)
- **핵심 종합 및 해석 제한**:
1. Adam 조건을 고정한 아키텍처 레인에서는 원본 이미지의 공간적 인덕티브 바이어스가 중요했습니다. `compact_cnn`은 파라미터가 MLP의 약 1/12인데도 정확도가 0.83%p 높았습니다.
2. 이 프로토콜의 30p × 40e·fixed-2k 예산에서 9,098개 전가중치를 직접 탐색한 순수 PSO는 36.76% ± 3.76%에 그쳐 역전파를 대체하지 못했습니다. 더 큰 예산에서의 이론적 한계를 증명한 결과는 아닙니다.
3. PSO 탐색 후 Adam을 적용한 `hybrid`도 97.30% ± 0.75%로, 추가 PSO 계산량을 사용하면서 동일 10-epoch pure Adam(98.53% ± 0.16%)보다 낮았습니다. 측정한 설정에서는 PSO 초기점이 이점을 제공하지 않았습니다.
4. 본 결과는 $n=3$ 기술적(descriptive) 표본 평가이며 보편적 성능 주장으로 확장하지 않습니다.
### Heavy PSO 고정 부분공간 반복 연구 (Heavy PSO Autoresearch 1.0.0)
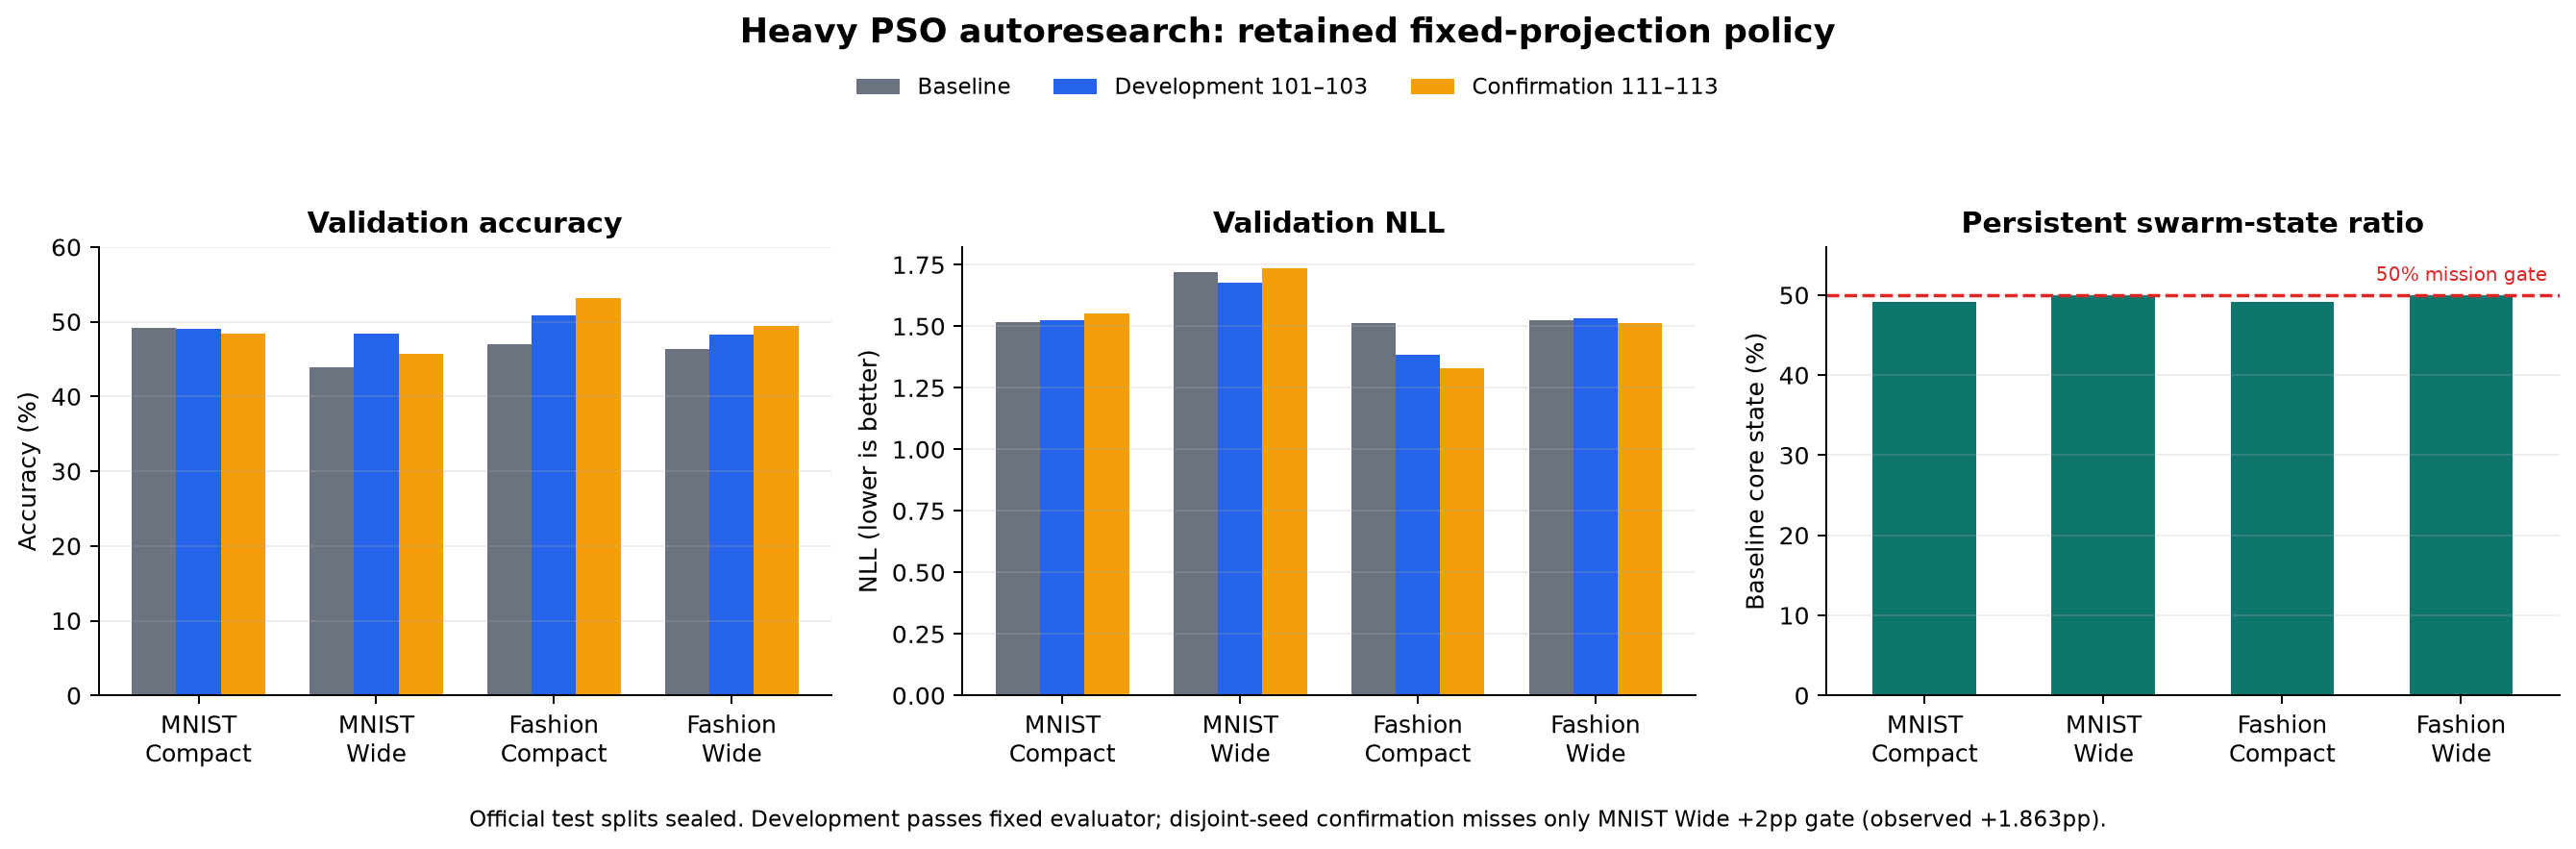
MNIST/FashionMNIST × CompactCNN/WideCNN 네 workload에서 공식 test split을 봉인하고, 12 particles × 80 epochs × fixed-10k 조건으로 signed-hash 부분공간의 validation 품질과 persistent swarm-state 절감을 반복 평가했습니다.
- 유지한 development 정책은 workload별 고정 global projection과 latent ratio 0.5를 사용해 baseline core state의 **49.18~50.00%**만 유지했습니다.
- Seeds 101~103에서는 평균 accuracy **+2.5333%p**, 상대 NLL **2.4968% 개선**으로 고정 evaluator의 모든 gate를 통과했습니다.
- 정책을 다시 선택하지 않은 seeds 111~113 confirmation은 평균 accuracy **+2.6342%p**, 상대 NLL **2.4955% 개선**이었지만, MNIST Wide 개선이 **+1.8633%p**로 사전 기준 +2%p에 0.1367%p 미달했습니다. 따라서 독립 확인된 Pareto 승리로 주장하지 않습니다.
- Tensor-local hash와 geometry multiplier 0.75/0.5는 기각했습니다. 두 seed 집합을 합친 6-seed 수치는 사후 기술 통계이며 gate 판정값이 아닙니다.
- **실행기**: [`test/heavy_pso_autoresearch.py`](test/heavy_pso_autoresearch.py)
- **고정 평가기**: [`test/evaluate_heavy_autoresearch.py`](test/evaluate_heavy_autoresearch.py)
- **결과**: [`benchmark_results/pso_v6_heavy_autoresearch.json`](benchmark_results/pso_v6_heavy_autoresearch.json), [`benchmark_results/pso_v6_heavy_autoresearch.csv`](benchmark_results/pso_v6_heavy_autoresearch.csv)
- **상세 반복 분석**: [`REPORT.md` §6.13](REPORT.md#613-고정-부분공간-pso의-품질상태-pareto-반복-연구-heavy-pso-autoresearch-100)
- **※ 주의 (후속 검증 결과)**: 후속 교차 분할 평가([`Heavy PSO 교차 분할 강건성 검증 (Heavy PSO Cross-Split 1.0.0)`](#heavy-pso-교차-분할-강건성-검증-heavy-pso-cross-split-100))에서 동일 정책이 개발 분할 평가 게이트를 통과하지 못했습니다. 따라서 본 절의 단일 개발 분할 수치는 새 validation split에 대한 강건성 증거가 아닙니다.
### Heavy PSO 교차 분할 강건성 검증 (Heavy PSO Cross-Split 1.0.0)
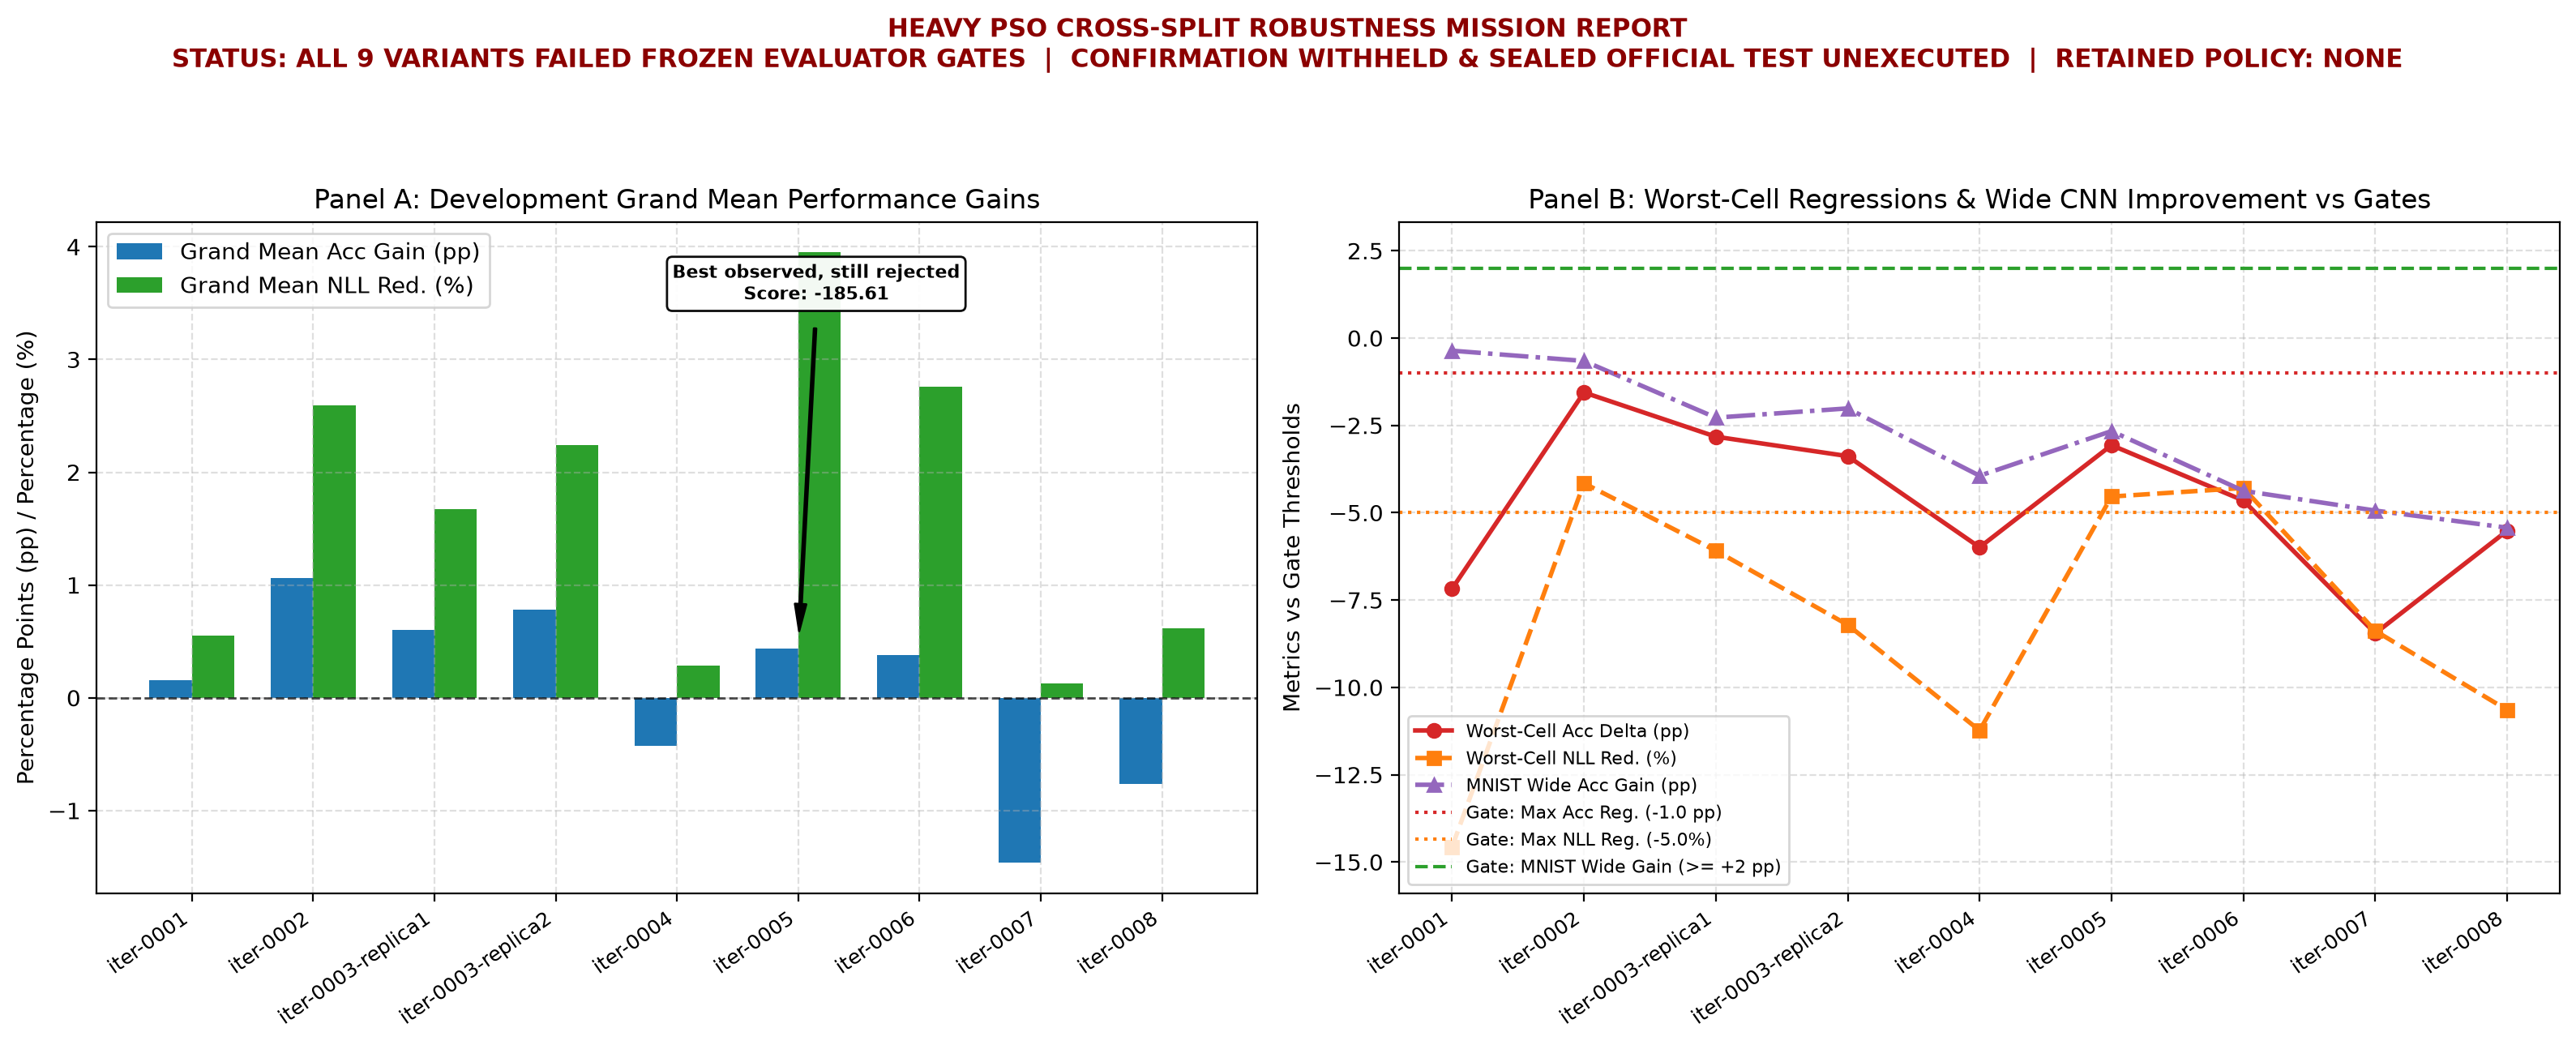
2개 개발 분할(split 20260905, 20260906) 및 시드 101~103, 매칭 baseline 재실행 조건(12 particles × 80 epochs × fixed-10k)에서 고정 부분공간 PSO의 새 validation split 재현성을 평가했습니다 (`HEAVY-PSO-CROSS-SPLIT 1.0.0`).
- **실험 설계 및 개념적 구분**:
- **결정 탐색 vs 개발 변형**: 총 8회 결정 탐색(Decision Iterations 1~8)을 수행하였으며, Iteration 3의 Replica 1/2를 포함하여 총 9개 개발 변형(Development Variants)을 평가했습니다.
- **개발 단계 vs 확인 단계**: 2개 무작위 개발 분할(20260905/20260906) 기반의 개발 평가를 먼저 수행하고, 개발 게이트를 모두 통과한 후보에 한해 확인 분할(20260907) 기반 확인 평가를 진행하도록 설계했습니다.
- **검증 분할 vs 공식 테스트**: 학습 50,000개 / 검증 10,000개 층화 분할(Search/Validation)을 사용했으며, 공식 테스트 스플릿(10,000개)은 0회 로드 및 0회 평가로 완전히 봉인 유지했습니다.
- **관측 최상위 vs 최종 보존**: 9개 개발 변형 중 관측 최상위 후보와 최종 보존 정책을 엄격히 구분했습니다.
- **주요 결과 및 판정**:
- **동결 정책 (`fixed_global_hybrid_v3`, Iteration 1)**: 전체 평균 정확도 개선 **+0.1533%p**, NLL 감소 **0.5546%**에 그쳤으며, 최악 accuracy 회귀 **-7.1767%p**, 최악 NLL 회귀 **+14.5682%**, MNIST Wide accuracy **-0.3617%p** (NLL **2.4600%** 악화)로 게이트를 통과하지 못해 **FAIL** 판정되었습니다.
- **관측 최상위 후보 (Iteration 5, Largest-Tensor Hash)**: 8회 결정 탐색 중 가장 높은 스코어(**-185.610686**)를 기록했으나, overall accuracy 개선 **+0.4400%p**, NLL 감소 **3.9493%**, 최악 accuracy 회귀 **-3.0667%p**, MNIST Wide accuracy **-2.6633%p** (NLL **2.1874%** 악화)로 역시 게이트 미달하여 **FAIL** 판정되었습니다.
- **확인 단계 보류 및 최종 보존 실패**: 9개 개발 변형 모두 개발 게이트를 통과하지 못함에 따라, 확인 분할(20260907) 실행은 과학적 엄격성 규칙에 따라 **실행하지 않고 보류(withheld)**되었으며, 최종 보존 정책은 `retained_policy = null`로 확정되었습니다. 공식 테스트 데이터 역시 0회 평가로 미사용 봉인 상태를 유지했습니다.
- **자원 사용량 및 실행 집계**:
- **총 실행 횟수 (Runs)**: 432회 (9개 변형 × 8개 개발 셀 × 6회 실행)
- **총 목적함수 쿼리 (Queries)**: 414,720회
- **총 샘플 평가 수 (Sample Evaluations)**: 4,147,200,000회 (41.472억)
- **합산 실행 시간 (Wall Time)**: 3,162.9717초 (~52.7분)
- **공식 테스트 데이터 로드 및 평가**: 0회
- **재현 및 아티팩트 발행 명령**:
```shell
# 1. 교차 분할 탐색 미션 실행 (개발 단계)
uv run --no-sync python test/heavy_pso_cross_split.py --phase development --device mps
# 2. 개별 변형 평가 실행 예시
uv run --no-sync python test/evaluate_heavy_cross_split.py --development .omc/autoresearch/heavy-pso-cross-split-robustness/runs/20260903T162504Z/candidates/iteration-0001-development.json --output .omc/autoresearch/heavy-pso-cross-split-robustness/runs/20260903T162504Z/evaluations/iteration-0001-development.json
# 3. 공개 아티팩트 및 시각화 생성 명령
uv run --no-sync python test/publish_heavy_cross_split.py --source-dir .omc/autoresearch/heavy-pso-cross-split-robustness/runs/20260903T162504Z --output-json benchmark_results/pso_v7_heavy_cross_split.json --output-csv benchmark_results/pso_v7_heavy_cross_split.csv --output-plot history_plt/pso_v7_heavy_cross_split.png
```
- **공개 아티팩트 및 분석 링크**:
- **공개 JSON**: [`benchmark_results/pso_v7_heavy_cross_split.json`](benchmark_results/pso_v7_heavy_cross_split.json)
- **공개 CSV**: [`benchmark_results/pso_v7_heavy_cross_split.csv`](benchmark_results/pso_v7_heavy_cross_split.csv)
- **공개 PNG 시각화**: [`history_plt/pso_v7_heavy_cross_split.png`](history_plt/pso_v7_heavy_cross_split.png)
- **실행기/평가기/발행기**: [`test/heavy_pso_cross_split.py`](test/heavy_pso_cross_split.py), [`test/evaluate_heavy_cross_split.py`](test/evaluate_heavy_cross_split.py), [`test/publish_heavy_cross_split.py`](test/publish_heavy_cross_split.py)
- **반복 결정 로그**: [`.omc/autoresearch/heavy-pso-cross-split-robustness/runs/20260903T162504Z/decision-log.md`](.omc/autoresearch/heavy-pso-cross-split-robustness/runs/20260903T162504Z/decision-log.md)
- **상세 보고서 구문**: [`REPORT.md` §6.14](REPORT.md#614-heavy-pso-교차-분할-강건성-검증-heavy-pso-cross-split-100)
### Post-Training Prediction-Space Ensemble 연구 (PSO v8)
이 연구는 일반적인 역전파 학습이 끝난 뒤, **서로 독립적으로 학습한 모델의 예측 확률을 결합**할 때 PSO가 유용한지와 그 비용을 측정했습니다. 모델 가중치를 섞는 model soup가 아닙니다.
#### 구조 및 평가 범위
- MNIST와 FashionMNIST 각각에서 9,098개 파라미터의 `CompactCNN`을 Adam으로 독립 학습한 5개 멤버(seed `201`~`205`)를 사용했습니다. 각 멤버는 10 epoch이며, 비교를 위해 동일한 seed `201`의 50-epoch 단일 모델도 유지했습니다.
- 탐색/검증 분할은 `50,000/10,000`개, split seed `20260904`이며 공식 test split은 개발 gate 통과 뒤에만 한 번 로드·평가했습니다. test 이후 재튜닝·재실행은 없습니다.
- 각 멤버의 검증 확률을 캐시해 `(5, 10,000, 10)` 텐서로 만들고, 학습 가능한 `raw_weights`에 `softmax`를 적용해 simplex 가중치 `w`를 얻습니다. 결합은 `p_ensemble = Σᵢ wᵢ pᵢ`이며 목적함수는 확률 공간의 NLL입니다. **멤버의 독립적인 신경망 가중치는 평균하지 않고, 예측 확률만 결합합니다.**
#### 공식 test 결과 (one-shot confirmation)
| 방법 | MNIST accuracy / NLL | FashionMNIST accuracy / NLL |
| --- | ---: | ---: |
| PSO 가중치 (`30 particles × 30 epochs`) | **98.83% / 0.036178** | **89.54% / 0.291700** |
| 균등 앙상블 | 98.86% / 0.036184 | 89.65% / 0.293522 |
| SLSQP 가중치 | 98.83% / 0.036179 | 89.54% / 0.291696 |
| 균등 앙상블 + temperature scaling | 98.86% / **0.034129** | 89.65% / **0.291996** |
| 동일 50-epoch 예산 단일 모델 | 98.60% / 0.062102 | 89.93% / 0.302348 |
PSO와 SLSQP는 두 workload에서 사실상 같은 NLL을 냈습니다. PSO를 동일 50-epoch 단일 모델과 비교하면 두 workload 평균 test NLL이 **22.633% 감소**했지만, 평균 accuracy는 **-0.08%p**였습니다. 이는 이 측정 조건의 기술적 결과이지 보편적 우위 주장이 아닙니다.
#### 비용과 권고
5개 독립 모델 pool은 단일 모델 대비 **저장 공간과 멤버 추론 비용이 5배**입니다. 또한 cached-probability simplex NLL은 매끄러운 저차원 문제였습니다. SLSQP는 workload당 **23회 평가 / 약 0.010초**로 PSO가 도달한 NLL을 재현했지만, PSO는 Iteration 1에서 swarm seed 하나당 **900회 평가 / 약 1.7~2.0초**가 필요했습니다. Iteration 0과 1을 합친 전체 PSO 연구 비용은 **14,400 queries / 144,000,000 candidate-sample evaluations / 30.2907초**입니다. 최종 Iteration 1만 보면 research **5,400 queries / 54,000,000 candidate-sample evaluations / 11.1512초**, 선택된 production **3.7888초**, SLSQP **46회 / 0.0201초**였습니다. Iteration 1의 production 시간과 해당 iteration의 pool 학습 시간 비율은 유지하지만, 두 iteration 합산 비용을 한 iteration의 학습 비용으로 나누지는 않습니다.
따라서 이 연구의 권고는 **예측 공간 앙상블 자체는 유효한 선택으로 검토하되, 이처럼 매끄러운 simplex NLL에는 먼저 균등+temperature scaling 또는 SLSQP를 사용**하는 것입니다. PSO는 동일 목적함수에 대한 연구 비교 대상으로는 남지만, 측정된 비용을 고려하면 기본 선택으로 권하지 않습니다. 관련 배경은 [Deep Ensembles](https://arxiv.org/abs/1612.01474), [Temperature Scaling](https://arxiv.org/abs/1706.04599), [Model Soups](https://arxiv.org/abs/2203.05482), [Git Re-Basin](https://arxiv.org/abs/2209.04836)을 참조하십시오. 여기서 Model Soups와 Git Re-Basin은 각각 가중치 결합/정렬 문제를 다루며, 본 실험의 **독립 모델 가중치 평균**을 의미하지 않습니다.
#### 재현 스크립트 및 공개 아티팩트
- 실행기: [`test/post_training_pso_ensemble.py`](test/post_training_pso_ensemble.py)
- 독립 평가기: [`test/evaluate_post_training_ensemble.py`](test/evaluate_post_training_ensemble.py)
- 결과 JSON: [`benchmark_results/pso_v8_post_training_ensemble.json`](benchmark_results/pso_v8_post_training_ensemble.json)
- 결과 CSV: [`benchmark_results/pso_v8_post_training_ensemble.csv`](benchmark_results/pso_v8_post_training_ensemble.csv)
- 평가 JSON: [`benchmark_results/pso_v8_post_training_ensemble_evaluation.json`](benchmark_results/pso_v8_post_training_ensemble_evaluation.json)
- 시각화: [`history_plt/pso_v8_post_training_ensemble.png`](history_plt/pso_v8_post_training_ensemble.png)
- 결정 로그: [`.omc/autoresearch/post-training-pso-ensemble/runs/20260904T093144Z/decision-log.md`](.omc/autoresearch/post-training-pso-ensemble/runs/20260904T093144Z/decision-log.md)
### 역사적 단일 시드 레퍼런스 (Historical Seed 42 Reference)
> **※ 참고**: 아래 기록은 초기 개발 단계에서 단일 시드(Seed 42) 환경으로 측정된 역사적(Historical) 레퍼런스 데이터입니다. 다중 시드($n=5$) 기반의 종합 실증 데이터 및 메타데이터는 상단 실증 보고서 및 [`REPORT.md`](REPORT.md)를 참조하십시오.
- **튜닝 프로필 PSO 전용 (`refinement="none"`)**: 검증 정확도 `60.30%` / 검증 손실 `1.2354`
- **튜닝 프로필 하이브리드 Adam 후처리 (`refinement="adam"`, 100 에포크 @ lr 0.01)**:
- 최종 검증 평가: 검증 정확도 `84.60%` / 검증 손실 `0.4848`
- 전체 fit 실행 시간: `3.10초` (Apple Silicon MPS)
---
## 출력 아티팩트 구조
`fit()` 실행 시 `output_dir`을 지정하면 다음과 같이 버전 4.0.0 메타데이터 구조를 포함하는 파일 아티팩트가 생성됩니다:
```plain
output_dir/
|-- best_model.pt # 최적 모델 state_dict 및 런 메타데이터
|-- checkpoints/ # checkpoint_interval 설정 시 세대별 체크포인트
| |-- epoch-25.pt
|-- history.csv # log_format="csv" 설정 시 학습 로그
|-- tensorboard/ # log_format="tensorboard" 이벤트 로그
|-- run.json # save_info=True 설정 시 5단계 플러그인 런 정보
```
### `run.json` 예시 (v4.0.0):
```json
{
"version": "4.0.0",
"task": "binary",
"device": "mps",
"loss_function": "BCEWithLogitsLoss",
"config": {
"method": "original",
"initialization": "model_noise",
"evaluation": "full",
"convergence": "none",
"refinement": "none",
"plugins": {
"movement": {
"title": "Original PSO",
"source": "10.1109/ICNN.1995.488968",
"gradient_required": false,
"fidelity": "canonical",
"options": {
"c0": 2.0,
"c1": 2.0
}
},
"initialization": {
"title": "Model Weight + Uniform Noise Initialization",
"source": null,
"gradient_required": false,
"fidelity": "canonical",
"options": {
"noise": 1.0
}
},
"evaluation": {
"title": "Full Dataset Evaluation",
"source": null,
"gradient_required": false,
"fidelity": "canonical",
"options": {}
},
"convergence": {
"title": "No Convergence Action",
"source": null,
"gradient_required": false,
"fidelity": "canonical",
"options": {}
},
"refinement": {
"title": "No Refinement",
"source": null,
"gradient_required": false,
"fidelity": "canonical",
"options": {}
}
},
"n_particles": 40,
"c0": 2.0,
"c1": 2.0,
"w_min": null,
"w_max": null,
"negative_swarm": 0.0,
"mutation_swarm": 0.0,
"particle_min": -5.0,
"particle_max": 5.0,
"velocity_limit_ratio": null,
"boundary_strategy": "clip",
"initial_position_noise": 1.0,
"seed": 101,
"fitness_size": null,
"convergence_patience": 10,
"convergence_min_delta": 0.0001,
"convergence_monitor": "loss",
"moment_blend": 0.0,
"moment_beta1": 0.9,
"moment_beta2": 0.999,
"moment_step_size": 1.0,
"moment_epsilon": 1e-08,
"epochs": 100,
"batch_size": null,
"renewal": "loss",
"refinement_epochs": 0,
"refinement_lr": 0.001,
"validation_source": null,
"validation_split": null,
"output_dir": "./result/xor",
"log_format": "csv",
"checkpoint_interval": 25,
"save_info": true
},
"best_training_score": [0.0, 1.0, 0.0],
"validation_score": null,
"validation_source": null,
"validation_sample_count": null
}
```
---
## 프로젝트 구조
```plain
.
|-- .github/
| |-- workflows/
| |-- pypi.yml # PyPI 게시 워크플로우
| |-- python-package.yml # GitHub Actions CI 워크플로우
|-- benchmark_results/ # Protocol 2.0.0 벤치마크 측정 결과 아티팩트
| |-- pso_v4_benchmark.json
| |-- pso_v4_main_benchmark.csv
| |-- pso_v4_ablation_benchmark.csv
| |-- pso_v4_tuning.json
| |-- pso_v4_tuning_search.csv
| |-- pso_v4_tuning_confirmation.csv
| |-- pso_v4_particle_scaling.csv
| |-- pso_v4_120p80_replication.json
| |-- pso_v4_120p80_replication.csv
| |-- pso_v4_epoch_convergence.json
| |-- pso_v4_epoch_convergence.csv
| |-- pso_v4_full_mnist.json
| |-- pso_v4_full_mnist.csv
| |-- pso_v4_deep_accuracy.json
| |-- pso_v4_deep_accuracy.csv
| |-- pso_v6_heavy_autoresearch.json
| |-- pso_v6_heavy_autoresearch.csv
| |-- pso_v7_heavy_cross_split.json
| |-- pso_v7_heavy_cross_split.csv
|-- data/ # 실험용 로컬 데이터셋
|-- example/
| |-- pso2mnist.ipynb # MNIST Jupyter Notebook 예제
|-- history_plt/ # 벤치마크 결과 시각화 이미지
| |-- pso_v4_accuracy.png
| |-- pso_v4_loss.png
| |-- pso_v4_rank_heatmap.png
| |-- pso_v4_runtime.png
| |-- pso_v4_mnist_ablation.png
| |-- pso_v4_extended_tuning.png
| |-- pso_v4_particle_scaling.png
| |-- pso_v4_epoch_convergence.png
| |-- pso_v4_full_mnist.png
| |-- pso_v4_deep_accuracy.png
| |-- pso_v6_heavy_autoresearch.png
| |-- pso_v7_heavy_cross_split.png
|-- pso/ # pso2keras 핵심 라이브러리 코드
| |-- __init__.py # Optimizer, Particle, __version__ 내보내기
| |-- _version.py # 패키지 버전 조회
| |-- _weights.py # PyTorch 파라미터 평탄화/복원 ParameterCodec
| |-- optimizer.py # Optimizer 클래스 및 5단계 오케스트레이션
| |-- particle.py # Swarm 파티클 구현
| |-- plugins.py # 5단계 플러그인 아키텍처 및 메타데이터/스테이지 구현
|-- test/ # 수동 수렴 실험 및 비교 스크립트
| |-- benchmark_suite.py # Protocol 2.0.0 종합 벤치마크 자동화 수트
| |-- tuning_suite.py # Tuning Protocol 1.0.0 검증 선택/확인/스케일링 수트
| |-- reproduce_scaling.py # 120p×80e 파티클 스케일링 재현성 검증 스크립트
| |-- epoch_convergence.py # Adaptive Moment 120p 연속 epoch 수렴 진단
| |-- full_mnist_study.py # 공식 MNIST 60k/10k 전체 학습 진단
| |-- deep_accuracy_study.py # 공식 MNIST 딥 신경망 원본 이미지/최적화기 비교
| |-- heavy_pso_autoresearch.py # Heavy PSO 부분공간 반복 실험기
| |-- evaluate_heavy_autoresearch.py # 고정 Pareto 평가기
| |-- heavy_pso_cross_split.py # Heavy PSO 교차 분할 실행기
| |-- evaluate_heavy_cross_split.py # 엄격한 교차 분할 평가기
| |-- publish_heavy_cross_split.py # 공개 JSON/CSV/PNG 발행기
| |-- cli.py # CLI 인자 파싱 및 스테이지 헬퍼
| |-- compare_methods.py # 다종 무브먼트 알고리즘 비교 CLI
| |-- xor.py
| |-- iris.py
| |-- mnist.py
| |-- fashion_mnist.py
| |-- digits.py
| |-- seeds.py
| |-- bean.py
|-- tests/ # 자동화 오프라인 pytest 테스트 수트
| |-- test_plugins.py # 플러그인 레지스트리 및 메타데이터 테스트
|-- LICENSE
|-- pyproject.toml # 프로젝트 메타데이터 및 의존성 정의
|-- README.md
|-- REPORT.md # PSO v4.0.0 실증 벤치마크 평가 보고서
|-- uv.lock # 의존성 잠금 파일
```
---
## 보안 관련 참고 사항
> **Note on Credentials**:
> 이전 README 파일에 포함되어 있던 Sonar 서비스 프로젝트 뱃지 URL에는 인증 토큰 키가 직접 표기되어 있었습니다. 해당 토큰 파라미터는 보안상 이 저장소에서 완전히 제거되었습니다. 기존 노출 토큰의 재발급 및 무효화(Revocation/Rotation) 작업은 해당 Sonar 대시보드 외부 서비스 관리 화면에서 별도로 관리됩니다.
---
## 참고 문헌 (Primary References & DOIs)
1. Kennedy, J., & Eberhart, R. (1995). *Particle swarm optimization*. In Proceedings of ICNN'95 - International Conference on Neural Networks (Vol. 4, pp. 1942-1948). IEEE. DOI: [10.1109/ICNN.1995.488968](https://doi.org/10.1109/ICNN.1995.488968)
2. Shi, Y., & Eberhart, R. (1998). *A modified particle swarm optimizer*. In 1998 IEEE International Conference on Evolutionary Computation Proceedings. IEEE World Congress on Computational Intelligence (pp. 69-73). IEEE. DOI: [10.1109/ICEC.1998.699146](https://doi.org/10.1109/ICEC.1998.699146)
3. Clerc, M., & Kennedy, J. (2002). *The particle swarm-explosion, stability, and convergence in a multidimensional complex space*. IEEE Transactions on Evolutionary Computation, 6(1), 58-73. DOI: [10.1109/4235.985692](https://doi.org/10.1109/4235.985692)
4. Mendes, R., Kennedy, J., & Neves, J. (2004). *The fully informed particle swarm: simpler, maybe better*. IEEE Transactions on Evolutionary Computation, 8(3), 204-210. DOI: [10.1109/TEVC.2004.826074](https://doi.org/10.1109/TEVC.2004.826074)
5. Liang, J. J., Qin, A. K., Suganthan, P. N., & Baskar, S. (2006). *Comprehensive learning particle swarm optimizer for global optimization of multimodal functions*. IEEE Transactions on Evolutionary Computation, 10(3), 281-295. DOI: [10.1109/TEVC.2005.857610](https://doi.org/10.1109/TEVC.2005.857610)
6. Kennedy, J. (2003). *Bare bones particle swarms*. In Proceedings of the 2003 IEEE Swarm Intelligence Symposium (pp. 80-87). IEEE. DOI: [10.1109/SIS.2003.1202251](https://doi.org/10.1109/SIS.2003.1202251)
7. Zhang, J.-R., Zhang, J., Lok, T.-M., & Lyu, M. R. (2007). *A hybrid particle swarm optimization–back-propagation algorithm for feedforward neural network training*. Applied Mathematics and Computation, 185(2), 1026-1037. DOI: [10.1016/j.amc.2006.07.025](https://doi.org/10.1016/j.amc.2006.07.025) (Hybrid PSO-BP Classical Foundations)
8. Kennedy, J., & Mendes, R. (2002). *Population structure and particle swarm performance*. In Proceedings of the 2002 Congress on Evolutionary Computation (Vol. 2, pp. 1671-1676). IEEE. DOI: [10.1109/CEC.2002.1004493](https://doi.org/10.1109/CEC.2002.1004493)
9. Sun, J., Feng, B., & Xu, W. (2004). *Particle swarm optimization with particles having quantum behavior*. In Proceedings of the 2004 Congress on Evolutionary Computation (pp. 325-331). IEEE. DOI: [10.1109/CEC.2004.1330875](https://doi.org/10.1109/CEC.2004.1330875)